Phiên bản đầu của trợ lý trả lời được mọi câu hỏi. Đó chính là vấn đề. Hỏi nó thứ mà tài liệu không hề đề cập, nó vẫn đưa ra câu trả lời tự tin, nghe hợp lý, và hoàn toàn bịa — tệ hơn là không có trợ lý nào, vì trả lời sai về chính sách hoàn tiền tốn kém hơn một trang trắng rất nhiều.
Truy hồi trước, sinh văn bản sau
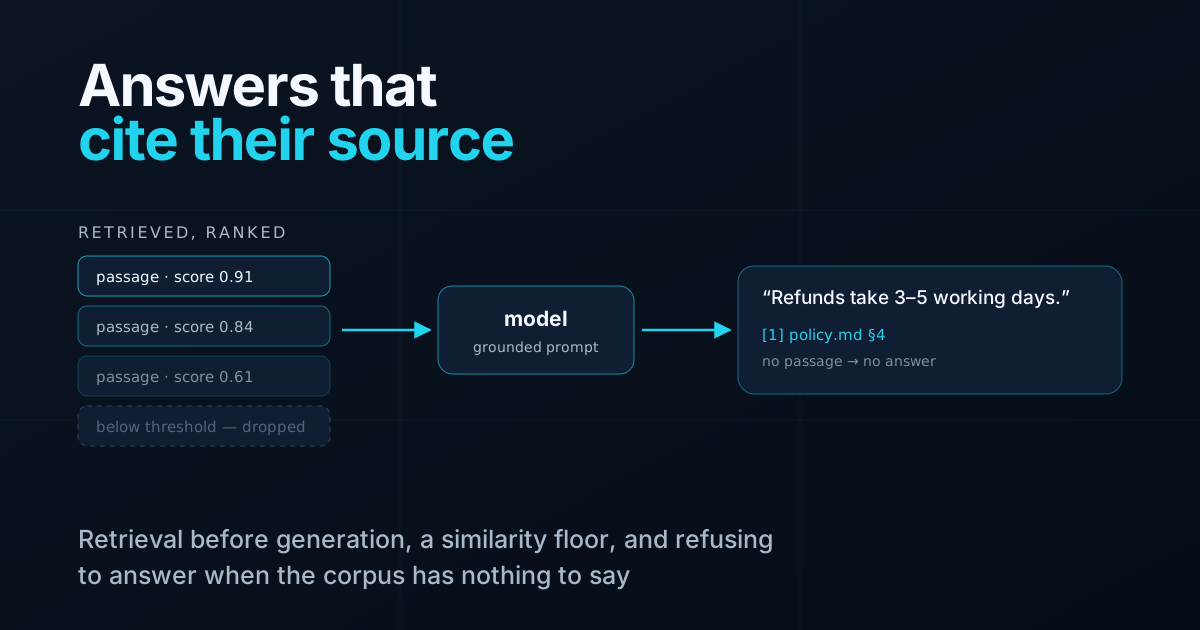
Một mô hình ngôn ngữ khi nhận câu hỏi trần sẽ trả lời bằng bất cứ thứ gì nó hấp thụ lúc huấn luyện. RAG đổi thứ tự: tìm trong kho tài liệu của bạn trước, nhét các đoạn tìm được vào prompt, rồi yêu cầu mô hình trả lời dựa trên những đoạn đó.
Mô hình thôi làm nguồn sự thật và chỉ còn làm việc diễn đạt. Đó là việc nhỏ hơn nhiều, và đáng tin hơn nhiều.
Cắt đoạn quyết định trần chất lượng
Mọi thứ phía sau đều bị giới hạn bởi cách kho tài liệu được cắt, và đây là chỗ thắng hoặc thua phần lớn chất lượng.
Đoạn quá lớn chôn câu văn cần tìm giữa hàng đoạn nhiễu, và vector nhúng bị trung bình hoá thành thứ khớp yếu với mọi câu hỏi. Đoạn quá nhỏ thì câu văn mất ngữ cảnh làm nên ý nghĩa của nó — "phải trả lại trong vòng 14 ngày" là vô dụng nếu không biết nó là cái gì.
Hai điều hiệu quả hơn hẳn việc chỉnh kích thước:
Cắt theo cấu trúc, đừng cắt theo số ký tự. Heading, mục danh sách, dòng bảng là những ranh giới tác giả đã chọn sẵn. Cắt mỗi 500 ký tự thì chặt ngang câu và trộn lẫn các phần không liên quan.
Mang heading vào trong đoạn. Thêm tiêu đề tài liệu và tên mục vào đầu mỗi đoạn tốn vài token, nhưng khiến một đoạn vốn mơ hồ trở nên tìm được. Đây là cải thiện chất lượng rẻ nhất có thể có.
Ngưỡng tương đồng, và sự sẵn lòng nói không
Vector search luôn trả về top k. Nó không có khái niệm "ở đây chẳng có gì liên quan" — hỏi về thời tiết thì nó vẫn đưa ra năm đoạn ít-lạc-đề-nhất về hoàn tiền.
Nên ngưỡng phải được đặt tường minh:
const hits = await search(embedding, { limit: 8 })
const relevant = hits.filter((hit) => hit.score >= SIMILARITY_FLOOR)
if (relevant.length === 0) return { answer: NO_ANSWER, sources: [] }
Trả lời "tài liệu của tôi không có phần này" là một câu trả lời đúng. Làm cho hệ thống chịu thừa nhận điều đó chiếm phần lớn khoảng cách giữa một trợ lý hữu ích và một gánh nặng, và ngưỡng này đáng được tinh chỉnh trên câu hỏi thật chứ không phải câu hỏi tưởng tượng.
Trích dẫn, và làm cho trích dẫn kiểm chứng được
Mọi câu trả lời đều kèm các đoạn đã dùng, và giao diện hiển thị chúng. Đây không phải trang trí — nó làm ba việc cùng lúc: người đọc kiểm chứng được mà không cần tin mô hình, một khẳng định không có căn cứ trở nên lộ ra thay vì im lặng trôi qua, và danh sách trích dẫn cho biết tài liệu nào thực sự đang gánh việc để bạn biết phải cập nhật cái gì.
Nếu mô hình viết ra một câu mà không đoạn trích nào chống đỡ, đó là một lỗi giờ đây bạn nhìn thấy được.
Cái giá của nó
Vector nhúng rẻ để tính và rất dễ quên vô hiệu hoá. Bài học phải trả giá mới học được: vector nhúng là một bản cache của tài liệu, và phải được vô hiệu hoá đúng như một bản cache. Lưu hash của đoạn cùng với vector rồi nhúng lại khi nó đổi, nếu không trợ lý sẽ rất tự tin trích dẫn một chính sách bạn đã viết lại từ tháng trước.
Độ trễ bằng truy hồi cộng sinh văn bản, và truy hồi là phần bạn kiểm soát được. Giữ k nhỏ và giữ ngưỡng trung thực rẻ hơn ta tưởng — ít đoạn nhưng đúng cho câu trả lời tốt hơn nhiều đoạn nhưng dở.
Nếu chỉ được giữ lại hai thứ
Trong toàn bộ pipeline đó, hai mảnh xứng đáng có mặt vô điều kiện: ngưỡng tương đồng, vì nó là thứ cho phép hệ thống sai ít hơn đúng, và trích dẫn nguồn, vì đó là thứ cho phép người khác kiểm tra. Phần còn lại chỉ là tinh chỉnh.