Có một con bug vượt qua mọi bài test bạn viết cho nó.
Một request tạo đơn hàng. Service commit row vào Postgres, rồi publish order.created lên Kafka để service tồn kho giữ hàng và khách nhận được xác nhận. Trong test, cả hai dòng đều chạy. Rồi một lần deploy restart container đúng vào khoảnh khắc giữa hai dòng đó. Đơn hàng thì có, còn sự kiện thì không bao giờ được gửi đi. Không service nào phía sau biết đến đơn này, và log cũng chẳng có dòng lỗi nào, vì với code thì không có gì sai cả: nó chỉ dừng lại thôi.
Lời giải quen thuộc là transactional outbox, và cái bảng outbox chỉ là 10% dễ nhất. Sự kiện bị mất hay bị trùng đến từ 90% còn lại: ai được gửi row nào, sender treo giữa chừng thì sao, consumer nhận ra một message mình đã xử lý bằng cách nào. Bài này dựng dần từng lớp, mỗi lớp bắt đầu từ một kiểu hỏng, với số liệu thật từ một nền tảng mười ba service NestJS, trong đó mười hai service có bảng outbox. (Còn vì sao sự kiện đi qua Kafka thì xem REST, gRPC hay Kafka.)
Hãy giữ trong đầu hình ảnh thư bảo đảm. Nhân viên bưu điện ghi lá thư vào sổ trước khi nó rời quầy, và người nhận phải ký nhận khi thư tới. Nhờ cuốn sổ, thư không thể biến mất mà không để lại dấu vết. Nhờ chữ ký, một lá thư bị giao hai lần sẽ bị phát hiện ở lần thứ hai. Thiếu một trong hai là hỏng.
Dual write là gì và vì sao nó làm mất sự kiện?
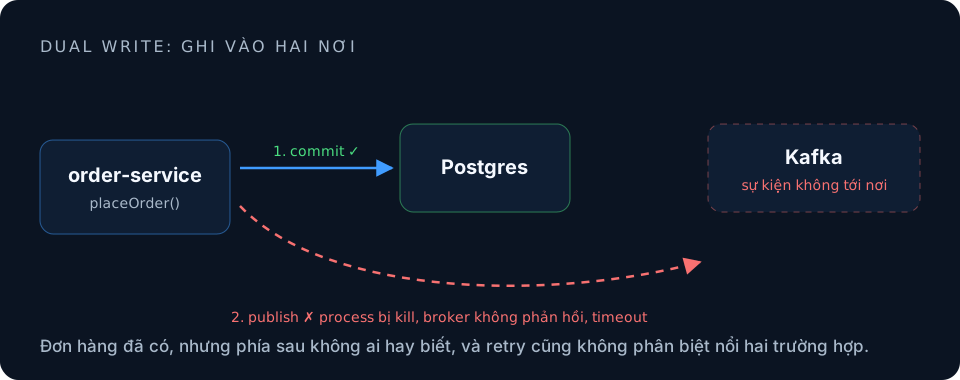
Dual write là ghi vào hai hệ thống mà không có transaction nào bao được cả hai:
await prisma.order.create({ data: order }); // 1. Postgres commit
await producer.send({                       // 2. Kafka, nếu còn kịp
  topic: 'order.created.v1',
  messages: [{ key: order.publicId, value: JSON.stringify(event) }],
});
Từng dòng thì atomic, nhưng cả cặp thì không. Giữa hai dòng là một process có thể bị kill, một broker có thể đang bầu leader, và một đường mạng có thể làm rơi ack sau khi broker đã ghi xong message. Chỉ cần một trong số đó là Postgres và Kafka mỗi bên hiểu một kiểu về chuyện vừa xảy ra.
Vì sao retry lệnh publish không cứu được?
Phản xạ đầu tiên là bọc dòng 2 trong retry. Nhưng retry chạy bên trong process, mà những lỗi đáng sợ lại kéo process đi theo: OOM kill, host reboot, deploy.
Timeout còn tệ hơn: bạn không phân biệt được "broker chưa hề nhận" với "broker nhận rồi nhưng ack bị mất". Retry là đúng trong trường hợp đầu, và thành publish hai lần trong trường hợp sau. Tức là retry biến sự kiện bị mất thành sự kiện bị trùng. Có tiến bộ, nhưng chưa phải atomic.
Đảo lại, publish trước rồi mới commit, thì chỉ lật ngược thiệt hại: commit hỏng thì để lại một sự kiện báo về một đơn hàng đã bị rollback. Idempotent producer của Kafka cũng không với tới đây; nó chỉ khử trùng các lần retry của chính nó trong một session và không biết gì về database của bạn.
Không có thứ tự nào biến hai lần ghi độc lập thành một. Vậy thì đừng ghi hai lần nữa.
Transactional outbox hoạt động thế nào?
Ghi sự kiện vào cùng database, trong cùng transaction với thay đổi nghiệp vụ. Sự kiện trở thành một row:
CREATE TABLE outbox_events (
  id                bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  event_id          uuid  NOT NULL UNIQUE,
  aggregate_id      uuid  NOT NULL,
  aggregate_version int   NOT NULL,
  event_type        text  NOT NULL,
  payload           jsonb NOT NULL,
  status            text  NOT NULL DEFAULT 'PENDING', -- PUBLISHING, PUBLISHED, DEAD
  attempt_count     int   NOT NULL DEFAULT 0,
  next_attempt_at   timestamptz NOT NULL DEFAULT now(),
  claim_token       uuid,
  claim_expires_at  timestamptz
);await prisma.$transaction(async (tx) => {
const order = await tx.order.create({ data: orderData });
await tx.outboxEvent.create({
data: {
eventId: createUuidV7(),
aggregateId: order.publicId,
aggregateVersion: order.version,
eventType: 'order.created.v1',
payload: { orderId: order.publicId },
},
});
});Hoặc cả hai row cùng commit, hoặc không row nào. Đó chính là dòng ghi vào sổ ở quầy: lá thư đã có tên trong sổ trước khi rời đi.
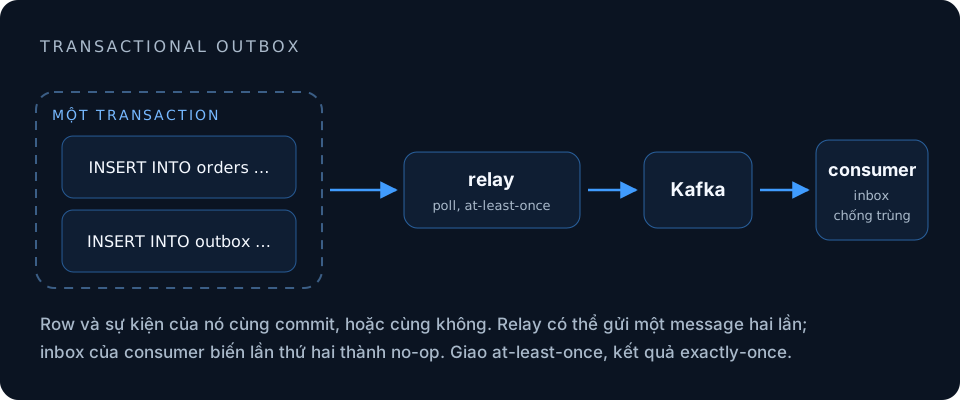
Một process riêng, gọi là relay, đọc các row đã commit và gửi lên Kafka. Relay crash thì các row cứ nằm đó chờ. Relay gửi xong một row nhưng chết trước khi kịp đánh dấu đã gửi thì sau khi khởi động lại, nó sẽ gửi row đó thêm lần nữa. Đây không phải bug để sửa sau; đây là hợp đồng. Outbox cho bạn at-least-once delivery, và phần còn lại của bài là chuyện sống chung với chữ "at least" đó.
Relay nên claim row như thế nào?
Một relay thì claim chẳng có gì khó. Nhưng bạn sẽ chạy hai relay cho chắc, và lúc đó cả hai cùng nhìn thấy những row đang chờ.
FOR UPDATE SKIP LOCKED làm gì?
FOR UPDATE khóa các row mà câu query trả về. SKIP LOCKED bảo các query khác bước qua row đang bị khóa thay vì đứng chờ. Mở hai session psql thử là thấy:
-- session A
BEGIN;
SELECT id FROM outbox_events WHERE status = 'PENDING'
ORDER BY id LIMIT 2 FOR UPDATE SKIP LOCKED;   -- trả về 1, 2

-- session B, trong lúc A vẫn đang mở
BEGIN;
SELECT id FROM outbox_events WHERE status = 'PENDING'
ORDER BY id LIMIT 2 FOR UPDATE SKIP LOCKED;   -- trả về 3, 4, không phải chờ
Không có SKIP LOCKED thì B đứng chờ A, và bạn vừa dựng một cách rất tốn kém để chạy đúng một worker. Không có FOR UPDATE thì cả hai cùng lấy row 1 và 2.
Sao không giữ lock trong lúc gửi?
Vì gửi là một lời gọi mạng. Giữ transaction mở trong lúc đó là giữ luôn một connection database, và khóa row suốt thời gian một lần gửi bị treo. Nên lock chỉ quyết định ai được lấy row; còn lease mới quyết định họ được giữ bao lâu. Order service claim và cấp lease trong một câu lệnh rồi commit ngay:
WITH candidates AS (
  SELECT id FROM outbox_events
  WHERE (status = 'PENDING'    AND next_attempt_at  <= now())
     OR (status = 'PUBLISHING' AND claim_expires_at <= now())  -- lease đã hết hạn
  ORDER BY id
  LIMIT 50
  FOR UPDATE SKIP LOCKED
)
UPDATE outbox_events AS e
SET status = 'PUBLISHING',
    claim_token = $1,                                -- UUID mới cho mỗi lần poll
    claim_expires_at = now() + interval '30 seconds',
    attempt_count = e.attempt_count + 1
FROM candidates
WHERE e.id = candidates.id
RETURNING e.*;
Relay này poll mỗi 5 giây, lấy tối đa 50 row, mỗi row có lease 30 giây. Row nào nằm ở PUBLISHING quá hạn lease sẽ claim lại được, và đó là thứ cứu bạn khi relay bị kill giữa chừng một batch.
Relay treo giữa chừng thì chuyện gì xảy ra?
Lease kéo theo một kiểu hỏng mới. Relay A claim một row lúc t = 0, rồi lần gửi bị treo 40 giây. Đến t = 30 lease hết hạn; relay B claim row đó, gửi đi và đánh dấu đã publish. Đến t = 40, lần gửi của A báo lỗi và A ghi "hẹn gửi lại row này". Thế là A vừa đẩy một sự kiện đã publish quay lại hàng đợi.
Claim token giống tờ phiếu giao có đánh số mà người đưa thư phải nộp lại. Mọi lần ghi sau khi claim đều phải khớp nó:
UPDATE outbox_events
SET status = 'PUBLISHED', claim_token = NULL
WHERE event_id = $1
  AND claim_token = $2         -- chỉ người đang giữ mới được hoàn tất
  AND status = 'PUBLISHING';
Lần ghi muộn của A giờ khớp 0 row. Nhưng để ý cái token không làm được: nếu lần gửi của A thành công lúc t = 40 thì Kafka đã có sự kiện đó hai lần. Kỹ thuật này gọi là fencing: mọi lần ghi sau khi claim phải chứng minh người ghi vẫn đang giữ row. Fencing ngăn người giữ cũ ghi đè trạng thái; nó không thu hồi được một message đã gửi. Trùng lặp vẫn là việc của consumer.
Khi nào một sự kiện nên thôi retry?
Gửi lỗi thì row quay về PENDING, với next_attempt_at lùi ra sau. Ở order service, khoảng chờ bắt đầu từ 1 giây và nhân đôi sau mỗi lần, có jitter ±20% để các relay không retry cùng một nhịp, trần là 15 phút. Sau 8 lần thử, một sự kiện bình thường bị đưa vào dead letter.
Tính thử trước khi tin con số đó. Các khoảng chờ 1, 2, 4, 8, 16, 32 và 64 giây cộng lại chỉ khoảng hai phút; cái trần 15 phút không bao giờ chạm tới. Kafka client có retry riêng bên trong mỗi lần thử, nhưng broker sập mười lăm phút vẫn đủ biến cả hàng đợi thành dead letter. Hãy đặt ngân sách retry theo thời gian ("chịu được broker sập 30 phút") rồi mới suy ra số lần thử.
Dead letter cũng đi bằng đường thư bảo đảm: row bị đánh dấu DEAD, và cùng transaction đó chèn một row outbox mới mô tả lỗi. Id của nó là createDerivedUuidV7(sourceEventId, deadLetterEventType): giữ phần timestamp của id gốc, phần còn lại lấy từ SHA-256 của id gốc cộng với event type của dead letter. Cùng đầu vào thì cùng id, nên lỡ bước dead letter có chạy hai lần thì lần chèn thứ hai sẽ đụng unique event_id, chứ không báo lỗi hai lần.
Event type chưa được map sang topic, hay payload không qua được bước validate envelope, thì vào dead letter ngay. Retry những trường hợp này chỉ để thất bại đủ tám lần.
Dùng aggregate làm key có giữ được thứ tự không?
Kafka chỉ giữ thứ tự trong một partition, ngoài ra thì không. Gửi với key: aggregateId thì mọi sự kiện của một đơn nằm chung một partition, nên order.cancelled không thể vượt order.created bên trong Kafka.
Nhưng relay có thể đảo thứ tự trước khi Kafka kịp thấy gì. Order service gửi mỗi batch song song. Nếu version 1 lỗi và bị hẹn gửi lại, trong khi version 2 gửi thành công, thì version 2 đi trước. Key đúng mà thứ tự vẫn sai.
Hai service chặn lỗ hổng này ngay lúc claim: không nhận một row khi version trước đó của cùng aggregate vẫn còn đang chờ.
AND NOT EXISTS (
  SELECT 1 FROM outbox_events earlier
  WHERE earlier.aggregate_id = candidate.aggregate_id
    AND earlier.aggregate_version < candidate.aggregate_version
    AND earlier.status IN ('PENDING', 'PUBLISHING')
)
Rồi bạn phải quyết định một predecessor đã chết nghĩa là gì. Một service bỏ row đã chết ra khỏi điều kiện, nên các sự kiện sau vẫn chảy và consumer sẽ thấy một khoảng hở version. Service kia chặn mọi thứ chưa gửi được, nên một sự kiện hỏng hẳn sẽ đóng băng cả luồng của aggregate đó cho tới khi có người vào xử lý. Cả hai đều có lý. Không quyết định gì mới là sai.
Vì sao consumer nào cũng cần inbox?
At-least-once nghĩa là sẽ có message đến hai lần. Consumer cũng có dual write của riêng nó: commit transaction database, rồi mới commit offset Kafka. Chết ở giữa là broker giao lại. Nên consumer giữ một cuốn sổ ký nhận, tức inbox, và kiểm tra nó trong cùng transaction với side effect.
Vì sao "kiểm tra rồi mới ghi" là chưa đủ?
Đoạn này nhìn thì đúng:
const seen = await tx.inboxEvent.findUnique({ where: { eventId } });
if (!seen) {
  await applySideEffect(tx, event);
  await tx.inboxEvent.upsert({ where: { eventId }, create: row, update: row });
}
Hai lần giao cùng một sự kiện chạy song song thì cả hai đều đọc ra null, cả hai đều áp side effect, rồi upsert biến lần insert thứ hai thành update thay vì báo lỗi. Unique constraint chỉ bảo vệ bạn khi bên thua bị lỗi. Chỉ cần một lần rebalance, hoặc một retry worker chạy cạnh consumer chính, là chuyện này xảy ra được. Decision record của pattern này vẫn còn ghi race đó trong phần xử lý inbox.
Cách đơn giản nhất là giành chỗ trước:
INSERT INTO inbox_events (event_id, payload_hash)
VALUES ($1, $2)
ON CONFLICT (event_id) DO NOTHING;
-- 1 row:  lần giao đầu tiên; áp side effect ngay trong transaction này
-- 0 row:  đã ký nhận rồi; so payload_hash rồi bỏ qua
Một lần insert song song với cùng key sẽ chờ transaction đầu xong rồi không làm gì cả. Một service khác đi đường khác: cả bước inbox chạy ở SERIALIZABLE và retry khi gặp unique violation hoặc serialization failure, tối đa năm lần. Dù chọn cách nào, cũng không constraint nào thu hồi được một side effect đã ra khỏi database (một email, một lời gọi HTTP). Hãy biến nó thành thêm một row outbox.
Inbox nên chống trùng theo khóa nào?
Mỗi kiểu trùng để lại một dấu vân tay khác nhau:
| Khóa | Bắt được | Bỏ sót |
|---|---|---|
event_id |
relay gửi một row hai lần | cùng một sự việc được phát lại với id mới |
| topic + partition + offset | broker giao lại vì mất commit offset | một row bị publish hai lần (hai offset) |
| producer + aggregate + version + type | cùng một sự việc dù mang id nào | không sót gì ở trên, nhưng cần sự kiện có version |
Hai inbox kỹ nhất trong nền tảng ép cả ba thành unique key. Nói gọn, đó là idempotency key, chỉ là áp cho message thay vì HTTP request.
Cùng event id mà payload khác thì sao?
Thì đó không phải bản trùng; đó là bug ở producer, hoặc một lần replay đã đổi dữ liệu. Envelope của order service mang theo hash của payload. Consumer cẩn thận sẽ so nó với hash đã lưu cho id đó, và đưa bản lệch vào dead letter thay vì lặng lẽ bỏ qua. Cùng mã vận đơn mà bên trong khác: đừng ký.
Version cũ và version đến sớm xử lý thế nào?
Lưu version cuối cùng đã xử lý cho từng aggregate:
- version ≤ last: cũ hoặc trùng. Ghi nhận rồi bỏ qua.
- version = last + 1: áp dụng.
- version > last + 1: đang thiếu gì đó. Tạm giữ lại (park).
Park thế nào cũng quan trọng. Dừng cả partition chờ khoảng hở được lấp thì đơn giản, nhưng sẽ kẹt cứng nếu sự kiện bị thiếu lại nằm phía sau bạn trong cùng partition, mà relay đảo thứ tự thì sinh ra đúng tình huống đó. Lưu sự kiện đến sớm sang một bên, commit offset, rồi để worker thử lại sau thì không bị kẹt. Cả hai cách đều có mặt trong nền tảng.
Order service park các saga outcome đến sớm, thử lại tối đa năm lần, sau đó từ chối outcome, chuyển saga sang MANUAL_RECOVERY và phát một sự kiện dead letter để người vào xử lý. Bài về saga giải thích vì sao cần trạng thái đó.
Row outbox và inbox nên giữ bao lâu?
Mỗi lần ghi nghiệp vụ thêm một row outbox, và row đó còn bị update ít nhất hai lần nữa trước khi thành PUBLISHED. Giữ mãi là mặc định, và là sai. Hiện mới có một service có retention worker: nó xóa row outbox đã publish và row inbox đã xử lý cũ hơn 30 ngày (mặc định; cấu hình được từ 7 đến 365), mỗi đợt 500 row. Ở các service khác, bảng cứ thế phình ra. Hai nguyên tắc khi đặt retention:
- Retention của inbox phải dài hơn cửa sổ giao lại dài nhất: retention của broker cộng với khoảng thời gian xa nhất bạn có thể replay. Xóa chữ ký đi thì bản sao tiếp theo của lá thư lại được ký thêm lần nữa.
- Đừng suy ra checkpoint từ những row sẽ bị xóa. Nếu "version cuối đã xử lý" được tính bằng
MAX(version)trên các row inbox, retention sẽ lặng lẽ xóa luôn checkpoint, và sự kiện kế tiếp của một aggregate lâu không hoạt động trông như một khoảng hở. Hãy để checkpoint ở bảng riêng. Service có retention đang tính version theo đúng kiểu này, và đó là cách tôi phát hiện ra.
Payload cũng là dữ liệu: order service mã hóa địa chỉ cá nhân ngay trong payload của sự kiện, thay vì để dạng văn bản thô trong một cái bảng không ai dọn.
Cái giá phải trả
- Độ trễ. Poll mỗi 5 giây nghĩa là sự kiện có thể chờ tới 5 giây mới đi, lâu hơn nếu đang backoff. Change data capture từ WAL bỏ được vòng poll, đổi lại phải vận hành thêm một hệ thống.
- Write amplification. Mỗi lần ghi nghiệp vụ kéo theo một lần insert, cộng các lần update khi claim và publish: thêm WAL, thêm việc cho vacuum, ngay trên database đang phục vụ request.
- Code. Mười hai relay. Chúng dùng chung helper (UUID, backoff, hash) nhưng không dùng chung relay hay inbox, và mỗi cái một kiểu: theo batch hoặc từng row, có hoặc không kiểm tra predecessor.
- Thứ tự chỉ tính trong từng aggregate, và chỉ khi bạn ép nó.
- Payload là hợp đồng. Row ghi trước một lần deploy sẽ được code sau lần deploy đó đọc, nên envelope mang
schemaVersionvà consumer phải chịu được field lạ.
Nếu làm lại, tôi sẽ làm khác gì?
Làm inbox trước. Outbox trông giống lời giải nên luôn được làm trước, rồi khi trùng lặp xuất hiện thì phần chống trùng mới được vá vội. Trùng lặp không phải tai nạn; nó là hợp đồng.
Một relay, một inbox, một bộ test. Tôi sẽ đưa cả hai vào thư viện dùng chung và test trên Postgres thật: chạy hai relay, kill một cái giữa lúc gửi, rồi assert rằng không mất gì và bản trùng bị chặn ở phía sau. Hiện unit test của một relay chỉ kiểm tra câu SQL claim có chứa FOR UPDATE SKIP LOCKED, mà như vậy thì chưa chứng minh được gì. Decision record nói thẳng điều này: pattern mới là mục tiêu với một prototype dang dở, trùng lặp vẫn có thể xảy ra, xử lý đồng thời và phục hồi sau crash chưa được chứng minh. Lease và claim token đã vào code sau khi decision record được viết, nhưng viết rồi chưa có nghĩa là đã chứng minh.
Quyết định chuyện thứ tự một cách có chủ đích, cho từng luồng: thứ tự có quan trọng không, predecessor chết có chặn không, và ai sẽ nhận cảnh báo khi nó chặn.
Đặt ngân sách retry bằng phút, không phải bằng số lần.
Tóm tắt
- Retry hay đảo thứ tự không làm dual write thành atomic được. Hãy ghi sự kiện vào cùng database, trong cùng transaction.
SKIP LOCKEDquyết định ai claim row, lease quyết định giữ bao lâu, còn claim token ngăn người giữ cũ ghi đè kết quả.- Fencing ngăn trạng thái bị hỏng, không ngăn gửi trùng. Inbox ở consumer mới làm cho việc xử lý thành effectively-once.
- Giành chỗ trong inbox bằng một lệnh insert sẽ lỗi hoặc không làm gì khi trùng; kiểm tra rồi upsert sẽ để lọt bản trùng.
- Dùng aggregate làm key chưa đủ để giữ thứ tự nếu relay có thể đảo. Ép thứ tự ngay lúc claim, hoặc bằng version ở consumer.
- Retention, ngân sách retry và dead letter là một phần của pattern, không phải việc dọn dẹp để sau.
Mọi sự kiện ở trên đều mang một UUIDv7 do ứng dụng tự tạo, và id của dead letter được suy ra từ sự kiện gốc. Vì sao ứng dụng tự tạo id thay vì để database làm là quyết định tiếp theo: UUIDv7 hay bigint làm khóa chính.