Trước khi nhận một đơn hàng, service order cần biết đúng một điều: kho có còn đủ hàng cho từng dòng trong đơn không? Dữ liệu tồn kho thuộc về service inventory. Trên máy tôi, database của hai service chạy chung một container Postgres, cách nhau vài mili giây. Nếu chúng chỉ là hai schema trong cùng một database, câu trả lời gói gọn trong một câu query:
-- Câu query tôi đã không viết
SELECT item.stock_item_id
FROM orders.order_items AS item
JOIN inventory.stock_items AS stock ON stock.id = item.stock_item_id
WHERE item.order_id = $1
  AND stock.on_hand - stock.reserved < item.quantity;
Query đó chạy nhanh, và nó sẽ lặng lẽ hàn hai service thành một. Bài này kể vì sao câu query ấy không tồn tại, thứ gì thay thế nó và cái giá của thứ thay thế. Bối cảnh là một nền tảng gồm mười ba service NestJS, mỗi service một database Postgres riêng, và cả mười ba database nằm chung một cụm.
Sao không JOIN thẳng sang bảng của service khác?
Hôm nay JOIN chạy ngon. Hóa đơn đến sau, theo ba kiểu.
Schema biến thành contract. Hôm nào inventory đổi tên cột on_hand, service order vỡ, và vỡ lúc chạy chứ không phải lúc compile. Từ đó mỗi migration của inventory đều phải chờ bên order gật đầu. Một thay đổi schema đã thành một đợt release phối hợp giữa hai service, đúng thứ mà việc tách service muốn tránh.
Câu trả lời chỉ đúng trong một khoảnh khắc. Giữa lúc đọc và lúc commit, một đơn khác có thể giữ mất chính những món hàng đó. Muốn câu trả lời còn đúng đến lúc commit thì service order phải lock các dòng của inventory ngay trong transaction của mình. Lúc đó một service đang cầm lock trên dữ liệu của service khác.
Không ai giữ luật. Tồn khả dụng (on_hand - reserved) không bao giờ được âm. Khi hai service cùng đụng vào các dòng đó, bên nào cũng nghĩ bên kia lo.
Đọc xuyên ranh giới service thật ra không phải là đọc. Đó là một sự phụ thuộc không có số phiên bản.
Database per service thực ra nghĩa là gì?
Mỗi service sở hữu một database logic: schema, migration và thông tin đăng nhập của nó. Service khác chỉ chạm tới dữ liệu đó qua API của chủ sở hữu (gRPC) hoặc qua event của chủ sở hữu (Kafka), không bao giờ qua bảng.
Ranh giới nên vẽ quanh những luật phải luôn đúng, chứ không vẽ quanh danh từ. Những dữ kiện phải thay đổi cùng nhau trong một transaction thì nằm chung một database: "tồn thực tế" và "đã giữ chỗ" phải luôn khớp nhau, nên inventory sở hữu cả hai. Còn đơn hàng và lượng hàng được giữ cho nó thì nằm ở hai service khác nhau. Khoảng hở đó chính là chủ đề của phần còn lại.
Trong repo, quyền sở hữu là thứ máy kiểm được. Một file catalog liệt kê mười ba dòng: service, database, login role, biến connection string và cấu hình migration. Một script từ chối nạp file nếu có dòng nào sai quy ước (order phải đi với order_db, order_app và ORDER_DATABASE_URL).
Mười ba database dùng chung một cụm Postgres có được không?
Được. "Mỗi service một database" chưa bao giờ có nghĩa là "mỗi service một server". ADR (architecture decision record, bản ghi quyết định kiến trúc) ghi rõ: dùng chung cụm vật lý là lựa chọn vận hành, không phải nới lỏng quyền sở hữu. Ở local, một container Postgres chứa cả mười ba database. Code hạ tầng cũng mô tả một instance managed dùng chung, dù trong repo chưa có gì chứng minh nó đã được dựng lên.
Vì sao tách database mà không tách schema?
Trong Postgres, một connection chỉ thuộc về một database: tài liệu về schema nói rõ connection chỉ chạm được dữ liệu trong database mà nó kết nối tới. Muốn sang database khác phải có dblink hoặc postgres_fdw, tức là phải có người cố ý cài. Còn hai schema chung một database thì chỉ cách câu query ở đầu bài đúng một lệnh GRANT. Tôi muốn lối tắt đó khó đi về mặt cấu trúc, chứ không chỉ là "trái quy định".
Làm sao chặn service này kết nối vào database của service khác?
Role nằm ở cấp cụm, còn mỗi database có quyền CONNECT. Vậy là đủ để dựng tường. Đây là phần bootstrap cho một service, rút gọn từ script init ở local (:'order_password' là biến của psql):
CREATE ROLE order_app WITH LOGIN NOSUPERUSER NOCREATEDB NOCREATEROLE
  NOINHERIT NOREPLICATION NOBYPASSRLS PASSWORD :'order_password';
CREATE DATABASE order_db OWNER order_app;

REVOKE CONNECT ON DATABASE order_db FROM PUBLIC;
REVOKE CONNECT ON DATABASE order_db FROM inventory_app, engagement_app; -- …và mười role còn lại
GRANT  CONNECT ON DATABASE order_db TO order_app;
Dòng PUBLIC là dòng hay bị quên nhất. Mặc định Postgres cấp CONNECT và TEMPORARY trên mọi database mới cho PUBLIC, nên thiếu lệnh revoke đó thì login role nào cũng mở được mọi database. Có nó rồi, kết nối nhầm sẽ hỏng đúng kiểu bạn muốn:
$ psql -U inventory_app -d order_db
psql: error: FATAL:  permission denied for database "order_db"
DETAIL:  User does not have CONNECT privilege.
Bản bootstrap cho môi trường cloud còn chặt hơn. Nó đọc ngược danh sách quyền của từng database và thu hồi CONNECT của mọi role trừ chủ sở hữu, từ chối role có thuộc tính superuser hay bỏ qua RLS, và từ chối connection URL có user hoặc database không khớp catalog. Một lưu ý: superuser bỏ qua toàn bộ kiểm tra quyền, nên credential admin chỉ được nằm trong job bootstrap.
Dùng chung cụm thì giữ được gì, mất gì?
Giữ được tường logic, mất tường vật lý:
| Khía cạnh | Một cụm, nhiều database | Mỗi service một cụm |
|---|---|---|
| Schema, migration, thông tin đăng nhập | Cô lập | Cô lập |
| JOIN hoặc foreign key xuyên service | Không làm được qua connection thường | Không làm được |
CPU, RAM, disk I/O, max_connections |
Dùng chung: một service ồn làm chậm tất cả | Tách riêng |
| Crash, restart, failover | Cả mười ba cùng lúc | Độc lập |
| Nâng major version | Một đợt cho tất cả | Từng service |
| Point-in-time recovery | Chỉ khôi phục cả cụm | Từng service |
Dòng cuối là dòng làm tôi bất ngờ. Cả cụm dùng chung một write-ahead log, và backup vật lý cộng WAL replay chỉ khôi phục được nguyên cụm, không khôi phục một phần. pg_dump thì làm theo từng database, nhưng chỉ chụp đúng thời điểm chạy. Muốn quay order_db về lúc 14:02, bạn phải khôi phục cả cụm ở chỗ khác về 14:02 rồi chép order_db trở lại. Quy trình đó nên diễn tập trước khi cần đến.
Bù lại có lối thoát: vì không service nào thò tay vào database của service khác, chuyển một service nặng ra server riêng chỉ là dump, restore và đổi một connection string.
Không có foreign key giữa các service thì lấy gì thay?
Đơn hàng không thể có foreign key trỏ sang khách hàng hay tenant, vì các dòng đó nằm ở database khác. Nó lưu tham chiếu dưới dạng giá trị:
model Order {
  id               BigInt      @id @default(autoincrement())
  publicId         String      @unique @db.Uuid
  tenantPublicId   String      @db.Uuid  // service khác sở hữu: có index, không bao giờ là foreign key
  customerPublicId String?     @db.Uuid  // service khác sở hữu
  status           OrderStatus @default(DRAFT)
  version          Int         @default(1)
  createdAt        DateTime    @default(now()) @db.Timestamptz(3)
  items            OrderItem[]           // cùng database: quan hệ thật

  @@index([customerPublicId, createdAt(sort: Desc), publicId(sort: Desc)])
}
Các tham chiếu này là public id dạng UUIDv7. Còn JOIN bên trong một database thì dùng khóa BIGINT, loại khóa không bao giờ rời khỏi service, như bài về UUIDv7 và khóa bigint giải thích. Ba thói quen gánh phần việc của foreign key.
Hỏi chủ sở hữu, kèm deadline. Có một luồng đặt đơn cần câu trả lời có hoặc không ngay lập tức. Ở đó service order hỏi inventory qua gRPC xem có đáp ứng đủ số lượng không. Lời gọi có deadline 2 giây, và câu trả lời kèm mốc thời gian asOf. Nếu inventory không trả lời kịp, đơn bị từ chối với mã 503 chứ không đoán bừa. Hãy coi câu trả lời đó là gợi ý, vì nó cũ ngay khi vừa tới. Sự bảo đảm thật đến sau, từ bước giữ hàng. (Khi nào dùng REST, gRPC hay Kafka có bài riêng.)
Chụp lại những gì sẽ cần. Mỗi dòng đơn chép tên, SKU, đơn giá, thuế suất và giảm giá tại thời điểm đặt. Catalog có sửa về sau cũng không viết lại lịch sử, và đọc một đơn cũ không cần gọi ai.
Chấp nhận tham chiếu treo. Một đơn có thể trỏ tới khách hàng mà hồ sơ đã bị ẩn danh hóa. Phía đọc phải chịu được chuyện đó, và lệch dữ liệu được phát hiện bằng cách đối soát từ event, chứ không được chặn bằng constraint.
Saga pattern là gì và chạy thế nào?
Giờ tới phần ghi. Đặt một đơn có thể đụng tới ba chủ sở hữu khác: inventory giữ hàng, engagement giữ coupon từ báo giá, delivery tạo job giao hàng nếu đơn cần giao. Trong một monolith, đó là một transaction. Ở đây là tối đa bốn database, và luật rất cứng: ghi xuyên service thì dùng saga, không bao giờ dùng distributed transaction ở tầng database.
Tôi hay hình dung nó như chuyển nhà qua ba công ty riêng biệt: bên đóng gói, bên xe tải và bên kho gửi đồ. Không có nút nào hủy được "cả vụ chuyển nhà". Nếu xe tải báo hủy sau khi bên đóng gói đã đóng thùng xong xuôi thì không có rollback. Bạn gọi bên đóng gói nhờ họ mở thùng ra, có khi còn mất phí. Thứ bạn có trong tay là một cuốn sổ: ai đã đặt, ai đã xác nhận, ai còn nợ câu trả lời. Saga chính là cuốn sổ đó, cộng với phương án cho từng cuộc gọi trục trặc.
Garcia-Molina và Salem đặt tên cho ý tưởng này trong bài báo Sagas năm 1987. Một transaction dài được tách thành chuỗi transaction cục bộ, mỗi cái tự commit. Nếu một bước sau thất bại, các giao dịch bù (compensating transaction) sẽ hóa giải tác dụng của những bước đã commit trước đó.
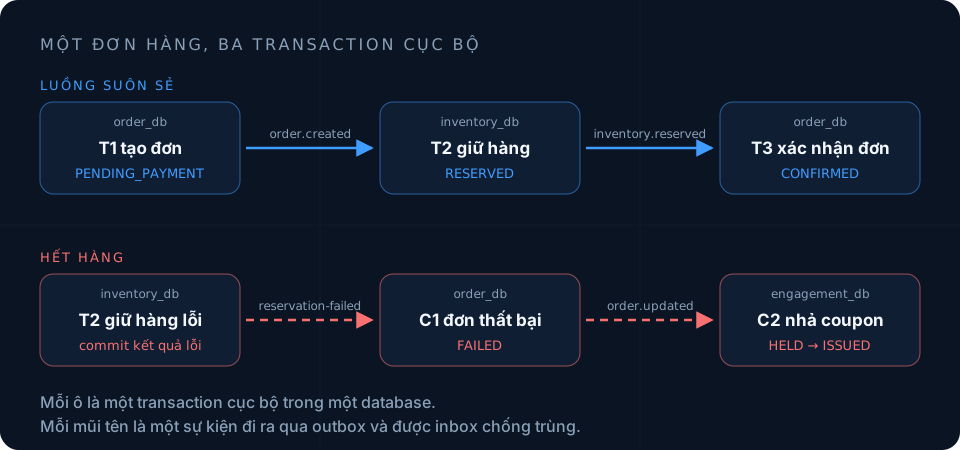
Sơ đồ đã nén bớt trạng thái. Trong code, mọi thứ chạy bằng bốn loại transaction cục bộ.
1. Mở sổ. Một transaction trong database của order chèn đơn ở trạng thái PENDING_INVENTORY, các dòng đơn và các dòng lịch sử. Cùng transaction đó chèn một dòng saga (loại CREATE, trạng thái STARTED, deadline 15 phút) và mỗi participant một step: luôn có RESERVE_INVENTORY, có HOLD_ENGAGEMENT nếu đơn có báo giá coupon, có CREATE_DELIVERY nếu đơn cần giao. Event order.created và yêu cầu giữ hàng đầu tiên vào outbox trong cùng lần commit.
2. Gửi lệnh. Các step còn lại, và mọi lần retry, thành các dòng command trong chính outbox đó. Relay publish chúng lên Kafka với key là id đơn, để message của cùng một đơn giữ đúng thứ tự. Mỗi command mang saga id, phiên bản đơn, participant, action, số lần thử và idempotency key dạng <sagaId>:<action>.
3. Từng participant làm phần việc của mình tại chỗ. Trong một transaction, participant claim command trong inbox, áp dụng thay đổi và ghi kết quả vào outbox của chính nó. Inventory đọc tồn kho trước, thiếu thì từ chối với INSUFFICIENT_STOCK. Sau đó nó ghi bằng một câu update kiểm lại đúng luật đó:
WITH requested(id, quantity, expected_version) AS (VALUES ($1::bigint, $2::numeric, $3::int))
UPDATE stock_items AS stock
SET reserved = stock.reserved + requested.quantity,
    version  = stock.version + 1
FROM requested
WHERE stock.id = requested.id
  AND stock.version = requested.expected_version
  AND stock.reserved <= stock.on_hand - requested.quantity
RETURNING stock.id;
Nếu có lượt giữ hàng khác chen vào giữa lúc đọc và lúc ghi, câu này không khớp dòng nào và không có gì bị bán lố. Còn thiếu hàng thật thì được commit thành một dữ kiện: succeeded: false, retryable: false.
4. Đọc phản hồi. Mỗi kết quả được xử lý trong một transaction riêng ở database của order: khử trùng lặp, đánh dấu step, quyết định bước tiếp. Khi mọi step đều thành công, đơn chuyển sang PENDING_PAYMENT, saga sang SUCCEEDED, dòng lịch sử và event order.updated commit cùng lúc. Khi một step thất bại hẳn, quá trình bù bắt đầu.
Sơ đồ vẽ theo kiểu choreography: service này phản ứng với event của service trước. Code thì dùng orchestration: service order gửi lệnh và ghi nhận phản hồi. Với ba participant, có retry, có deadline và có bù, tôi muốn có đúng một dòng dữ liệu cho biết đơn đang chờ cái gì.
Giao dịch bù có phải là undo không?
Không. Rollback thì xóa dấu vết. Giao dịch bù thì thêm một dữ kiện mới để hóa giải dữ kiện cũ. Bên đóng gói mở thùng ra là làm thêm một việc nữa, và hóa đơn ghi cả hai việc.
Mỗi step đã thành công có một bước bù tương ứng: RELEASE_INVENTORY cho lượt giữ hàng, REVERSE_ENGAGEMENT cho lượt giữ coupon, CANCEL_DELIVERY cho job giao hàng. Mỗi bước bù là một step mới với idempotency key riêng, được gửi đi như mọi command khác. Chỉ khi tất cả đều báo thành công thì đơn mới thành FAILED và saga thành COMPENSATED, trong cùng transaction trả lại suất mà đơn đã chiếm trong hạn mức đơn đang mở của tenant.
Mô hình dữ liệu cũng theo đúng luật đó. Điểm, tồn kho và thanh toán là các sổ cái chỉ ghi thêm (append-only), và sửa sai nghĩa là ghi một bút toán đảo có liên kết tới bút toán gốc. Khi một saga sửa đơn hỏng giữa chừng, đơn không bị tua ngược. Service ghi một revision mới có nội dung giống bản cũ, nên số phiên bản chỉ tăng, không bao giờ lùi.
Hold giúp việc bù rẻ hơn hẳn. Coupon chưa bị tiêu lúc báo giá, chỉ bị giữ, và lượt giữ có hạn riêng. Nếu saga chết giữa chừng mà không ai bù, lượt giữ tự hết hạn, giống như chỗ đặt ở kho gửi đồ tự hủy khi bạn không đến.
Có những tác dụng không bù được. Bạn không thể "gửi ngược" một thông báo hay "giao ngược" một kiện hàng. Hãy quyết định điểm không thể quay lại nằm ở đâu: đặt các bước không đảo ngược được ở cuối, hoặc sau một luồng có quyền đặc biệt rõ ràng.
Trạng thái của saga nằm ở đâu?
Trong hai state machine, cả hai đều là các dòng trong database của order. Mỗi lần đơn đổi trạng thái là một câu update có điều kiện:
const moved = await tx.order.updateMany({
  where: { id: saga.orderId, version: saga.orderVersion, status: 'PENDING_INVENTORY' },
  data: { status: 'PENDING_PAYMENT', version: { increment: 1 } },
});
if (moved.count !== 1) throw new SagaOutcomeConflictError();

await tx.orderStatusHistory.create({
  data: {
    orderId: saga.orderId,
    fromStatus: 'PENDING_INVENTORY',
    toStatus: 'PENDING_PAYMENT',
    reasonCode: 'SAGA_SUCCEEDED',
    correlationId: outcome.correlationId,
  },
});
Không có chuyện đọc rồi mới ghi. Mệnh đề WHERE chính là state machine. Nếu đơn đã bị hủy trong lúc đó, hoặc một message trùng đã đẩy nó đi rồi, sẽ không có dòng nào khớp, code ném lỗi và cả transaction rollback. Lịch sử commit trong cùng transaction, nên audit trail không thể lệch với trạng thái. Còn chuyện trả lại cho request retry đúng câu trả lời cũ thay vì báo xung đột là một bài toán khác, nằm trong bài idempotency key và optimistic locking.
Saga có bộ trạng thái riêng: STARTED, WAITING, COMPENSATING, SUCCEEDED, COMPENSATED, FAILED và MANUAL_RECOVERY, kèm một deadline. Step là duy nhất theo bộ ba saga, participant và action, nên message trùng không thể đẻ ra step "giữ hàng" thứ hai.
Participant không bao giờ trả lời thì sao?
Quay lại cuốn sổ: bên xe tải không nghe máy. Bạn gọi lại sau một phút, rồi năm phút, rồi một tiếng, và đến một lúc thì đành nhờ người xử lý. Code làm y như vậy. Cứ 5 giây, một scheduler đi tìm các step đến hạn và các saga quá deadline. Trước khi gửi lại, nó claim step: một câu update có điều kiện tăng số lần thử và đẩy lần thử kế tiếp ra 90 giây sau như một lease, để hai replica không bao giờ gửi trùng cùng một command. Lỗi có thể retry được giãn cách theo 1 giây, 5 giây, 30 giây, 2 phút và 10 phút, có jitter ±20%. Sau sáu lần thử, step chuyển sang MANUAL_RECOVERY và một event dead-letter được ghi lại.
Cả saga có deadline 15 phút. Quá hạn mà không còn gì đang chạy thì bắt đầu bù. Nếu saga vốn đang bù rồi thì tự động hóa đã hết nước đi, và saga chuyển sang MANUAL_RECOVERY.
Đó là một trạng thái thật, không phải một dòng log. Lối ra duy nhất là replay, và replay đòi một quyền riêng, role chủ sở hữu service và một lý do viết rõ ràng. Nó lock dòng saga, đặt lại các step chưa xong, cấp thêm 15 phút mới và ghi lại ai đã làm, vì sao.
Message đến hai lần, đến trễ hay đến sớm thì sao?
Kafka giao ít nhất một lần, nên mọi kết quả đều đi qua inbox trong cùng transaction với tác dụng của nó:
- Đã thấy rồi (trùng event id): bỏ qua. Trùng id mà payload khác: xung đột.
- Đến sớm (saga chưa biết, hoặc phiên bản đơn mới hơn): tạm gác lại rồi thử lại sau. Quá năm lần thì bị từ chối và đẩy vào dead-letter.
- Đến muộn (saga đã xong, hoặc đơn không khớp): ghi nhận là bị từ chối, không bao giờ áp dụng.
Cái giá phải trả
- Người dùng thấy trạng thái lưng chừng. Một đơn có thể nằm ở
PENDING_INVENTORYvài giây hoặc vài phút, và giao diện phải nói rõ điều đó. - Nhiều bảng hơn hẳn. Saga, step, outbox, inbox, lịch sử và revision đều là state không thể xóa mà không làm hỏng replay.
- Xử lý lỗi chiếm phần lớn. File điều phối saga đặt đơn dài khoảng 1.400 dòng, và phần lớn số đó dành cho những lúc có chuyện trục trặc.
- Báo cáo không JOIN được mười ba database. Nó dựng read model từ event và trả về
asOfkèm mọi câu trả lời. - Dùng chung cụm thì dính chung sự cố. Một câu query chạy mất kiểm soát hay một chỗ rò connection của một service là chuyện của tất cả.
Khi nào không nên tách database?
Khi một team ship một khối deploy duy nhất, modular monolith cho bạn transaction thật mà không tốn gì. Dữ liệu phải đổi cùng nhau thì nên thuộc về một chủ; thấy mình thèm distributed transaction thường nghĩa là ranh giới đang vẽ sai. Và nếu không kham nổi chuyện xây bù và phục hồi cho từng bước, bạn cũng chưa kham nổi việc tách.
Nếu làm lại, tôi sẽ làm khác gì?
Giữ ADR khớp với catalog. ADR-0005 vẫn ghi "11 database logic", trong khi catalog đã có mười ba dòng từ khi thêm hai service. Máy kiểm catalog, còn văn xuôi thì không ai kiểm. Tôi sẽ để ADR trỏ thẳng tới catalog thay vì ghi một con số.
Đặt trần cho từng role. Postgres cho phép giới hạn số connection theo role (ALTER ROLE order_app CONNECTION LIMIT 20) và đặt statement_timeout riêng cho từng role. Hiện chưa cái nào được đặt. Trên một cụm dùng chung, đây là cách rẻ nhất để chống hàng xóm ồn ào.
Diễn tập khôi phục một service. ADR treo việc chấp thuận cho tới khi topology, backup, buổi diễn tập khôi phục, quy trình migration và kiểm soát truy cập được ghi lại. Chưa mục nào được kiểm chứng.
Viết bảng lỗi trước. Với mỗi step, ghi rõ cái gì bù nó, bước bù có thể hỏng không và ai sẽ nhận cảnh báo. Lease, tạm gác message và phục hồi thủ công dễ thiết kế từ đầu hơn nhiều so với vá vào một happy path đã chạy.
Tóm tắt
- JOIN xuyên service biến schema của service này thành contract của service kia. Hãy đi qua API hoặc event của chủ sở hữu.
- Tách database trên cùng một cụm giữ được tường logic, nhưng chỉ khi bạn revoke
CONNECTkhỏiPUBLIC. - Dùng chung cụm là chấp nhận mất cô lập vật lý: chung tài nguyên, chung vùng sự cố, và point-in-time recovery chỉ làm được cho cả cụm.
- Tham chiếu xuyên service là giá trị cộng snapshot. Lời gọi đồng bộ phải có deadline và chỉ được coi là gợi ý.
- Saga là chuỗi transaction cục bộ cộng các bước bù được thiết kế trước, và mỗi bước bù là một dữ kiện mới.
- Đặt state machine trong mệnh đề
WHERE, và biếnMANUAL_RECOVERYthành một trạng thái thật, có audit.
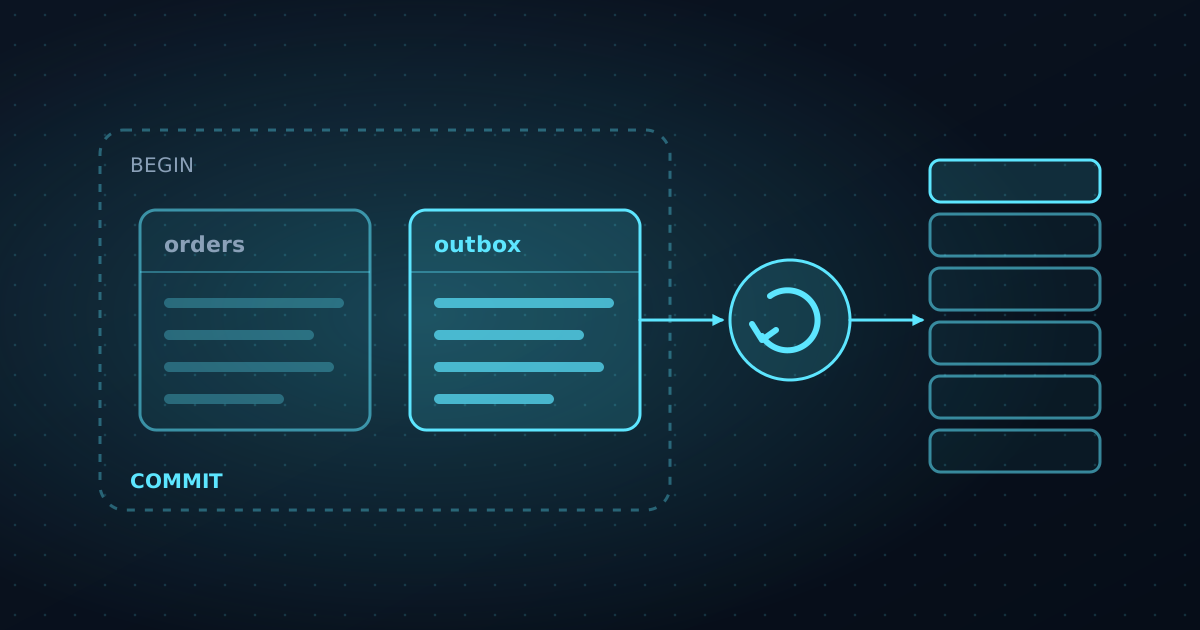
Mỗi mũi tên trong saga này là một message phải rời một database và tới một database khác, không được mất và không được áp dụng hai lần. Transactional outbox và inbox là cách làm điều đó.