Mười ba service NestJS, một cụm Postgres, một Kafka broker, Redis và một API gateway. Trên laptop, chỉ một lệnh docker compose up là tất cả cùng chạy. Nên rất dễ nghĩ: cứ chạy đúng lệnh đó trên một máy EC2 là thành production. Và cũng rất dễ nghe câu phản bác: microservice "đúng nghĩa" thì phải chạy trên Kubernetes.
Cả hai đều bỏ qua một bước. Thử nhìn hai sự cố mà cùng một stack Compose có thể gặp.
Sự cố một. Stack khởi động xong, lời gọi đầu tiên từ service này sang service kia lỗi ECONNREFUSED. Không service nào hỏng cả. Compose khởi động chúng đúng thứ tự bạn khai báo, chỉ là nó chờ sai thứ.
Sự cố hai. Bạn ship một bản sửa bằng docker compose up -d order, và trong vài giây gateway trả về 502. Không có gì crash. Compose thay container đúng như thiết kế.
Sự cố một là lỗi cấu hình, Compose sửa được bằng vài dòng. Sự cố hai thì không phải lỗi. Nó là bản chất của việc chạy trên một máy, và không flag nào của Compose xóa được nó. Phân biệt được hai loại vấn đề này là đã giải xong phần lớn câu hỏi "Compose hay Kubernetes".
Nói trước về bằng chứng: nền tảng này vẫn là prototype. Những gì bên dưới mô tả repository (các file Compose boot được toàn bộ stack, Terraform và pipeline cho bước tiếp theo), không phải kết quả production. Ranh giới đó nằm ở đâu, tôi sẽ chỉ rõ.
Deploy thật ra phải làm những việc gì?
Hình dung chuyện giao hàng. Một chiếc xe với một tài xế có thể xếp hàng, chạy tuyến, chết máy thì đề lại. Thứ một chiếc xe không làm được là vẫn giao hàng khi nó đang nằm trong xưởng, hay khi nó đã lật xuống mương. Muốn vậy bạn cần thêm xe và một người điều phối: người biết xe nào đang chạy, cho xe dự phòng xuất bến trước rồi mới gọi xe cũ về, và đổi tuyến khi một xe mất liên lạc.
Deploy cũng tách đúng theo đường ranh đó, thành hai danh sách việc.
Danh sách một: mô tả và khởi động.
- Build mỗi service một image.
- Đưa cho từng container config và secret của nó.
- Khởi động theo thứ tự phụ thuộc, và chờ tới khi từng cái sẵn sàng, chứ không chỉ là đang chạy.
- Cho các service tìm thấy nhau bằng tên.
- Process crash thì khởi động lại, và giữ lại log.
Danh sách hai: vẫn phục vụ trong lúc mọi thứ thay đổi và hỏng hóc.
- Thay phiên bản mà không làm rơi request.
- Sống sót khi mất trọn một máy.
- Rải container ra nhiều máy, thêm máy khi tải tăng.
- Chỉ gửi traffic tới instance đã qua health check.
- Tự rollback khi phiên bản mới mãi không healthy.
Compose trên một host làm tốt danh sách một và gần như không làm gì ở danh sách hai, vì mục nào ở đó cũng cần máy thứ hai và một người điều phối quyết định cái gì chạy ở đâu. ECS và Kubernetes đều là người điều phối. Vậy câu hỏi thật không phải "Compose hay Kubernetes?" mà là "mình đã cần danh sách hai chưa?". Chưa thì Compose là đủ. Rồi thì chọn một người điều phối, và Kubernetes hiếm khi là lựa chọn đầu tiên.
Docker Compose trên một host cho bạn những gì?
Repository có hai file Compose. compose.yml chỉ chạy hạ tầng: Postgres 17, một node Kafka 4.1 ở chế độ KRaft, Redis 8.2 tắt persistence, và gateway (Kong ở chế độ DB-less). compose.dev.yml thêm đủ mười ba service, mỗi service một image riêng, cộng một container migration chạy một lần cho từng service. Có ba thói quen trong hai file này đáng học theo.
Một anchor cho phần cấu hình dùng chung. Service nào cũng kế thừa restart policy, network và điều kiện phải có một Postgres đã healthy:
x-service-defaults: &service-defaults
  restart: unless-stopped
  depends_on:
    postgres:
      condition: service_healthy
  networks: [dev]
Port chỉ bind vào loopback. Port nào được publish cũng có dạng 127.0.0.1:3005:3005. Trên một máy EC2, điều đó nghĩa là port database bạn quên gỡ cũng không lọt ra ngoài, kể cả khi security group đang mở hơi rộng.
Thiếu biến bắt buộc thì dừng ngay. Secret nào không có giá trị mặc định an toàn thì được khai báo bằng ${NAME:?NAME is required}, nên docker compose up dừng lại kèm thông báo, thay vì khởi động service với một key rỗng.
"Started" trong Docker Compose có phải là "ready" không?
Không, và đó chính là sự cố một. Trong file dev, các container hạ tầng có health check còn các service thì không. Vì vậy một service gọi sang service khác chỉ có thể chờ condition: service_started, tức là "process đã tồn tại", chứ chưa phải "đã listen". Một service NestJS cần vài giây để kết nối database và bind port.
Đây là cuộc đua đó, tách riêng ra. Lưu thành race.yml rồi chạy docker compose -f race.yml up --abort-on-container-exit:
services:
  auth:
    image: node:24-alpine
    # Chỉ listen sau năm giây, giống một service đang khởi động.
    command: ["node", "-e", "setTimeout(() => require('node:http').createServer((req, res) => res.end('ready')).listen(3000), 5000)"]
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1:3000"]
      interval: 1s
      retries: 30
  order:
    image: node:24-alpine
    depends_on:
      auth:
        condition: service_started
    command: ["node", "-e", "fetch('http://auth:3000').then((res) => res.text()).then(console.log)"]
order chết với fetch failed, nguyên nhân là ECONNREFUSED. Đổi service_started thành service_healthy, chạy lại, khoảng năm giây sau nó in ra ready.
Bản sửa thật cần một thứ để probe, và service nào cũng có sẵn. Một controller NestJS dùng chung phục vụ /health/live, chỉ báo process còn sống, và /health/ready, trả 503 cho tới khi gRPC health status của service báo SERVING. Trỏ health check của Compose vào /health/ready, cho các service phụ thuộc nhau bằng service_healthy, vậy là hết sự cố một. Nhớ tách bạch hai endpoint: liveness trả lời "có nên restart nó không?", còn readiness trả lời "có nên gửi traffic cho nó không?".
Vì sao migration chạy trong một container riêng?
Mỗi service có một bản sinh đôi, ví dụ order-migrate, build từ cùng Dockerfile nhưng khác stage (migration thay vì runtime). Nó chạy prisma migrate deploy rồi thoát; image runtime không bao giờ tự migrate lúc boot. Khi đã có hai replica, nếu không tách ra thì cả hai sẽ tranh nhau migrate. Một job chạy một lần biến "đổi schema" và "khởi động code" thành hai bước bạn chủ động sắp thứ tự, và pipeline ECS ở phần sau giữ nguyên cách tách này.
Một host production còn cần gì nữa?
Docker phải được bật lúc boot thì restart policy mới còn tác dụng sau khi máy khởi động lại. Log phải được xoay vòng, vì driver json-file mặc định không rotate nếu bạn không đặt max-size. Mỗi container phải có giới hạn bộ nhớ, không thì một service rò rỉ bộ nhớ sẽ khiến OOM killer chọn nạn nhân trên toàn máy, mà nạn nhân rất có thể là Postgres. Và backup phải nằm ngoài máy. Tất cả vẫn thuộc danh sách một.
Chạy trên một host thì phải đánh đổi những gì?
Giờ tới sự cố hai. Probe một route bất kỳ đi qua gateway tới service, rồi redeploy chính service đó:
# Terminal 1: cứ 200 ms gửi một request, in ra status code.
URL=localhost:8000/orders/health/ready   # route nào đi tới service cũng được
while true; do
  printf '%s %s\n' "$(date +%T)" "$(curl -s -o /dev/null -w '%{http_code}' "$URL")"
  sleep 0.2
done

# Terminal 2: ship phiên bản mới của một service.
docker compose up -d --force-recreate order
Bạn sẽ thấy một loạt mã 5xx trong khoảng từ lúc container cũ dừng tới lúc container mới sẵn sàng. Compose tạo lại container bằng cách dừng cái cũ trước, và khi mỗi service chỉ có một container thì traffic chẳng còn chỗ nào để đi.
Bạn có thể viết script để lách: chạy hai replica, tạo lại lần lượt từng cái. Nhưng script đó chính là mảnh đầu tiên của một người điều phối tự viết bằng tay.
Phần còn lại của cái giá:
- Cả host là một failure domain. Một instance, một availability zone, một ổ đĩa. Mất nó là mọi service, database và broker cùng sập. Restart policy không thể khởi động lại một cái máy đã mất.
- Kafka không có replica. Một broker nghĩa là replication factor bằng 1, và mỗi lần restart nó thì mọi producer, consumer đều phải đứng chờ. Transactional outbox giữ cho khoảng dừng đó không làm mất sự kiện, vì sự kiện nằm chờ trong Postgres, nhưng dừng thì vẫn là dừng.
- Database ở chung máy. Cách tách database per service vốn đã nằm trên một cụm Postgres. Trên một host, cụm đó còn phải chia CPU, bộ nhớ và ổ đĩa với mười ba process Node.js.
- Chỉ scale được theo chiều dọc, mà đổi cỡ một instance EC2 thì phải dừng máy.
Với một prototype, một công cụ nội bộ hay vài người dùng đầu tiên, cái giá đó thường chấp nhận được. Miễn là bạn trả nó một cách có ý thức, và quyết định từ trước điều gì sẽ khiến bạn dừng lại.
Docker Compose, ECS và Kubernetes khác nhau ở đâu?
| Compose trên một EC2 | ECS trên EC2 | Kubernetes (EKS) | |
|---|---|---|---|
| Failure domain | Một host | Nhiều host, nhiều AZ | Nhiều node, nhiều AZ |
| Redeploy | Dừng rồi mới chạy | Rolling, chờ health check | Rolling, chờ health check |
| Bản mới bị lỗi | Bạn tự phát hiện | Circuit breaker tự rollback | Rollout đứng; bạn tự rollback |
| Service discovery | DNS của Compose | Cloud Map | DNS của cluster |
| Bạn phải vận hành | Một VM | Instance, task definition | Nâng cấp, add-on, manifest |
Nói theo chuyện xe: Compose là một chiếc xe. ECS giống thuê một hãng vận tải có sẵn tổng đài điều phối làm theo luật của AWS: bạn giao bảng kê hàng và chấp nhận cách họ làm việc. EKS cho bạn thuê sẵn văn phòng tổng đài, nhưng nhân viên điều phối thì bạn vẫn phải tự tuyển, tự đào tạo: ingress controller, cách inject secret, autoscaling cho node, lịch nâng cấp phiên bản. Kubernetes cho bạn nhiều quyền kiểm soát việc điều phối nhất, và quyền đó chỉ đáng tiền nếu bạn thật sự dùng tới. (Ô rollback ghi như vậy là có chủ ý: một Deployment bị đứng vẫn giữ pod cũ phục vụ, nhưng Kubernetes không tự hoàn tác giúp bạn.)
Khi nào nên rời khỏi một host duy nhất?
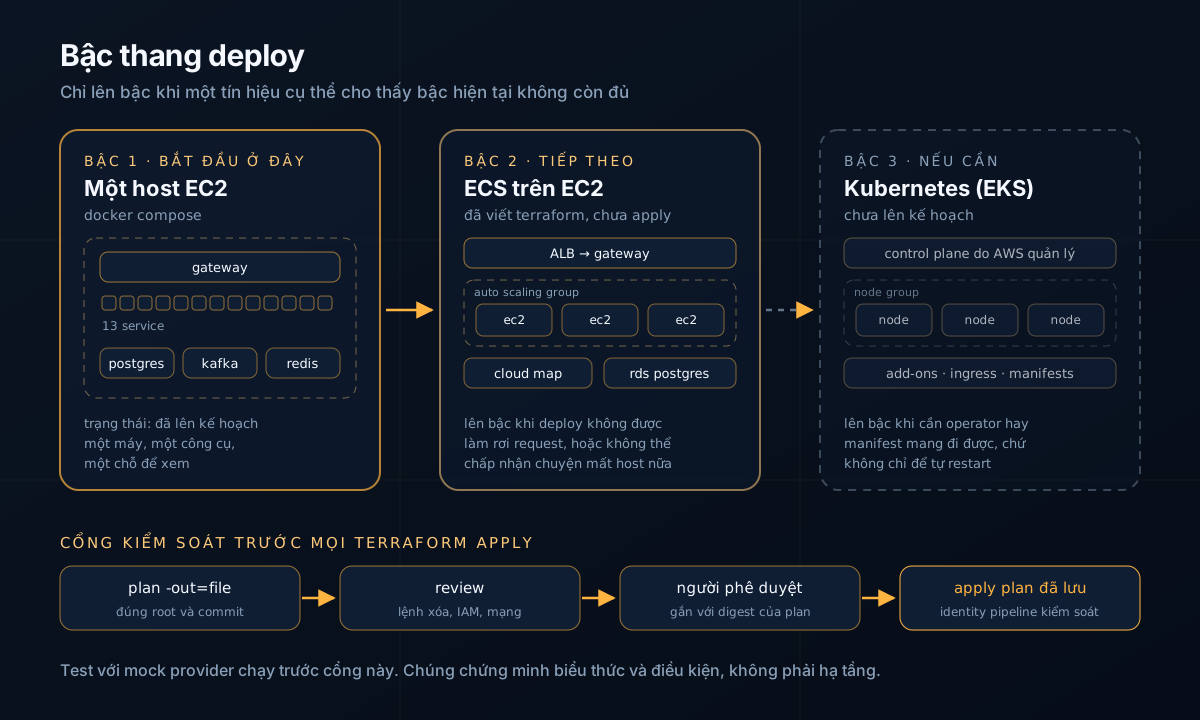
Chuyển khi xuất hiện một tín hiệu gọi được tên, chứ không phải khi sơ đồ kiến trúc bắt đầu trông có vẻ đơn sơ:
- Khoảng trống lúc redeploy bắt đầu lộ ra. Người dùng thấy loạt
5xx, hoặc bạn bắt đầu canh nửa đêm mới deploy để giấu nó. - Mất host trở thành điều không chấp nhận được. Ai đó ghi ra một mục tiêu thời gian phục hồi mà "dựng lại máy từ backup" không đáp ứng nổi.
- Một máy không còn đủ. Bạn đã nâng cỡ máy một lần, và cỡ tiếp theo đắt hơn việc chia tải ra nhiều máy.
Gặp bất kỳ tín hiệu nào trong số này thì bậc tiếp theo là một người điều phối được quản lý sẵn.
Vì sao chọn ECS trước Kubernetes?
Bước từ một host lên bất kỳ người điều phối nào đã phủ gần hết danh sách hai, và ECS đưa bạn tới đó với ít thứ mới phải học nhất: AWS chạy scheduler, không có control plane phải nâng cấp, và nó dùng luôn IAM, load balancer, secret mà đằng nào bạn cũng dùng.
Lên Kubernetes khi bạn cần thứ chỉ nó có: operator vận hành giúp các hệ thống có state, manifest muốn mang qua nhiều cloud, hoặc bộ công cụ mà team đã quen tay. "Biết đâu sau này cần" không phải là tín hiệu. Cùng một image chạy được trên cả ba bậc, nên khi leo bậc, thứ bạn viết lại là bản mô tả deploy, không phải code.
Điều đó chỉ đúng khi image nào cũng "thật thà": boot từ artifact của chính nó, không mượn gì từ workspace nơi nó được build. Đó là lý do Nx monorepo copy từng bản build ra ngoài và boot riêng nó trong CI.
Bản ECS trong repository trông thế nào?
Bậc hai được viết bằng Terraform, chia thành bốn root module: bootstrap (bucket chứa state và danh tính của pipeline), ecr (kho image), platform (network, ECS cluster, load balancer, RDS, secret) và services (mỗi ứng dụng một ECS service, cộng thêm Kafka, Redis và gateway). Task chạy trên một Auto Scaling group gồm các instance EC2, mỗi task có network interface riêng; thậm chí có một validation từ chối luôn các instance burstable dòng t, vì chúng không hỗ trợ ENI trunking mà chừng ấy interface đòi hỏi. Ở bậc một, bạn chẳng bao giờ phải biết những chuyện như vậy.
ECS redeploy mà không có khoảng trống bằng cách nào?
Mỗi service ứng dụng mặc định chạy một task, minimum healthy percent là 50, maximum là 200, kèm một circuit breaker có rollback:
resource "aws_ecs_service" "service" {
  for_each = local.service_catalog

  desired_count                      = var.service_desired_count              # 1
  deployment_minimum_healthy_percent = var.deployment_minimum_healthy_percent # 50
  deployment_maximum_percent         = var.deployment_maximum_percent         # 200

  deployment_circuit_breaker {
    enable   = true
    rollback = true
  }
}
Tính thử một chút, vì đây là chỗ người điều phối chứng minh giá trị của mình. ECS làm tròn lên với mức tối thiểu và làm tròn xuống với mức tối đa. Với một task mong muốn, 50% làm tròn lên thành 1, nên task cũ buộc phải tiếp tục chạy; 200% là 2, nên được phép chạy thêm một task bên cạnh. Vậy ECS khởi động bản mới, chờ nó qua health check, rồi mới dừng bản cũ. Xe dự phòng rời bến trước khi xe cũ được gọi về. Còn nếu bản mới mãi không healthy, circuit breaker sẽ rollback về lần deploy thành công gần nhất.
Health check của mỗi container gọi /health/live mỗi 30 giây (timeout 5 giây, thử lại 3 lần, start period 30 giây), load balancer kiểm tra /health của gateway, còn các service tìm thấy nhau qua một private DNS namespace của Cloud Map.
Service nào vẫn còn khoảng trống?
Kafka. Nó chạy đúng một task với cấu hình ngược lại, minimum 0 và maximum 100: dừng broker cũ rồi mới chạy broker mới, vì hai bản của cùng một broker không thể chạy song song. Bậc hai không mang lại high availability cho Kafka; nó chỉ giúp các service xung quanh roll êm. Chạy nhiều broker hay dùng Kafka managed là một quyết định khác, với cái giá riêng.
Terraform viết xong có phải là hạ tầng đã dựng?
Không. Pipeline để dựng toàn bộ chỗ này có mười hai stage:
quality → plan_ecr → apply_ecr → publish_images
        → plan_platform → apply_platform → bootstrap_database → migrate_services
        → plan_services → apply_services → verify → protected_operations
Có hai điều trong đó tôi sẽ mang theo tới bất kỳ dự án nào. Plan ra file, apply đúng file đó: mỗi job plan ghi -out=<name>.tfplan thành artifact, và job apply tương ứng dùng chính xác file ấy, nên không commit mới nào chen vào giữa được. Mỗi lúc chỉ một lần apply: apply của platform và services, bootstrap database và migration dùng chung một resource group đặt theo tên môi trường, nên hai pipeline không thể cùng lúc thay đổi một môi trường.
Hơn chục file terraform test chạy với mock provider. Chúng chứng minh biểu thức tính ra đúng và validation có chạy, chứ không chứng minh được AWS chấp nhận request hay có task nào thật sự healthy.
Và đây là ranh giới tôi đã hứa. Chưa có lần apply nào được ghi nhận. Repository không có output của môi trường nào, cũng không có dấu vết stage verify từng pass. Decision record về topology deploy vẫn ở trạng thái Planned, và hoãn việc chọn nền tảng cho tới khi chốt được số service, lưu lượng, mục tiêu phục hồi và ai chịu trách nhiệm vận hành. Một stage được định nghĩa không phải là một stage đã chạy, và nói "đang chạy trên ECS" sẽ là một tuyên bố không có gì chống lưng.
Khoảng hở tôi sẽ bịt trước lần apply thật đầu tiên là cái nằm ở cuối sơ đồ. Hiện tại các job apply chạy tự động trên protected branch. Tôi sẽ đặt một bước phê duyệt bằng người giữa plan và apply, gắn với digest của đúng file plan, và bắt buộc với mọi plan có xóa tài nguyên hoặc đụng tới IAM hay network. Mock test vẫn đứng trước cổng đó; chỉ là chúng không thay được nó.
Mỗi lựa chọn tốn những gì?
Compose trên một host rẻ nhất, cả về tiền chạy lẫn công sức để hiểu; bạn trả bằng khoảng trống lúc redeploy và việc phục hồi thủ công. ECS thêm load balancer, NAT gateway, RDS, dung lượng dư để task thứ hai có chỗ chạy trong mỗi lần deploy, và rất nhiều Terraform: riêng module platform đã khai báo 13 security group với 25 rule. EKS thêm phí control plane tính theo cluster, cộng thời gian của con người để vận hành chính Kubernetes.
Giai đoạn nửa nọ nửa kia cũng có giá của nó: hai bản mô tả cho cùng một hệ thống, và chúng có thể lệch nhau. Thực tế đã lệch một chỗ. Task definition của ECS có health check cho mọi service; stack Compose dev thì không.
Nếu làm lại, tôi sẽ làm khác điều gì?
- Thêm health check cho service trong Compose, trỏ vào
/health/ready, và cho các service phụ thuộc nhau bằngservice_healthy. Khi đó stack local sẽ cư xử giống môi trường đích. - Đối chiếu Compose với Terraform trong CI: cùng danh sách service, port và tên biến. Lệch thì build phải fail, đừng để nó lộ ra giữa một sự cố.
- Không để "live" trả lời quá sớm. ECS cho mỗi container đúng một health check, vừa dùng để thay task hỏng vừa dùng để gác rollout. Trỏ nó vào
/health/livethì tránh được chuyện giết task mỗi khi một dependency chập chờn, nhưng lại để task mới trông như healthy trước khi thật sự sẵn sàng. Tôi sẽ cho mỗi service chỉ bind port HTTP khi các dependency của nó đã lên. - Tính giá Fargate trước khi chốt dùng EC2. Fargate xóa hẳn câu hỏi về ENI trunking và cỡ instance, đổi lại giá mỗi task cao hơn.
- Giữ decision record khớp với code. Record nói "hoãn chọn nền tảng", còn Terraform nằm ngay bên cạnh đã chọn ECS trên EC2. Lập trường nào cũng bảo vệ được. Giữ cả hai cùng lúc thì người đọc sau sẽ rối.
Tóm tắt
- Deploy là hai danh sách việc. Compose lo phần "mô tả và khởi động". Phần "vẫn phục vụ khi mọi thứ thay đổi và hỏng hóc" cần nhiều hơn một máy và một scheduler.
- Started không phải là ready. Health check cộng
service_healthysửa được race lúc khởi động trong Compose; tách bạch liveness và readiness. - Trên một host, Compose dừng container cũ rồi mới chạy container mới. Khoảng trống đó là bản chất của một máy, không phải bug.
- Chuyển khi có tín hiệu gọi được tên: khoảng trống lúc deploy đã lộ, mục tiêu phục hồi mà một máy không đáp ứng nổi, một máy đã chạy hết công suất.
- Chọn ECS trước Kubernetes, trừ khi bạn cần operator, manifest mang đi được, hoặc công cụ chỉ Kubernetes mới có.
- Terraform viết xong không phải là hạ tầng đã dựng. Plan ra file, apply đúng file đó, đặt cổng phê duyệt, và đừng bao giờ nhận một stage chưa từng chạy.
Phân biệt một stage chỉ có trên giấy với một stage đã thật sự chạy càng khó hơn khi AI agent viết luôn cả pipeline, và đó là chỗ bài kiểm chứng code do AI agent viết bắt đầu.
Well done