Giả sử API của bạn trả về một đơn hàng ở /orders/1042. Chạy ổn, test xanh. Rồi cái URL đó rời khỏi tay bạn.
Một người dùng tò mò sửa 1042 thành 1041 rồi bấm Enter. Một đối thủ đặt một đơn hôm thứ Hai, một đơn hôm thứ Sáu, lấy hai số trừ nhau là biết mỗi tuần bạn có bao nhiêu đơn. Một team khác chép 1042 vào bảng của họ, thế là một số thứ tự vốn chỉ có nghĩa bên trong một database giờ nằm luôn trong dữ liệu của người khác.
URL không có lỗi gì cả. Lỗi nằm ở chỗ bắt một cột làm hai việc khác nhau. Trên một nền tảng mười ba service NestJS, tôi tách hai việc đó ra: bản ghi nào bên ngoài có thể trỏ tới thì có một primary key bigint cho database, và một UUIDv7 cho mọi thứ còn lại.
/orders/1042 để lộ những gì?
Ba thứ, và chỉ thứ đầu tiên là chuyện bảo mật.
Bản ghi hàng xóm. Id tuần tự chẳng khác gì mời người ta đếm. Chỉ cần một endpoint quên kiểm tra quyền sở hữu, một vòng lặp sẽ tìm ra nó trước cả pentester:
for id in $(seq 1 5000); do
  code=$(curl -s -o /dev/null -w '%{http_code}' -H "Authorization: Bearer $TOKEN" "$API/orders/$id")
  [ "$code" = 200 ] && echo "readable: $id"
done
Lượng đơn của bạn. Hai id cộng hai ngày là ra tốc độ tăng trưởng. Ước lượng tổng số từ số seri là bài toán xe tăng Đức (German tank problem) kinh điển, và bộ đếm đơn hàng của bạn chính là số seri.
Cách bạn lưu dữ liệu. Khi service khác đã lưu 1042, bạn không còn đánh số lại, gộp hai database hay chuyển bản ghi sang shard khác được nữa, vì sẽ làm gãy tham chiếu của họ. Id từng là chi tiết cài đặt. Giờ nó thành contract.
Còn một vấn đề thứ tư, âm thầm hơn: 1042 chưa tồn tại cho tới khi database cấp nó. Code nào cần id trước khi insert, chẳng hạn để gắn vào event, đều phải chờ thêm một round trip.
Rốt cuộc định danh dùng để làm gì?
Hãy nghĩ tới một khách sạn.
Bên trong, mọi thứ chạy theo số phòng. Danh sách dọn phòng, hóa đơn minibar, phiếu sửa chữa đều ghi "412". Số phòng ngắn, tăng dần và gắn với vị trí thật: 412 nằm cạnh 413, nhân viên đi thẳng tới đó.
Bên ngoài, bạn nhận một mã đặt phòng. Website cấp mã này trước khi có phòng nào được xếp, và nó nằm trong email xác nhận, ở xe đưa đón sân bay, ở đại lý du lịch. Nếu phòng 412 vỡ ống nước và khách sạn chuyển bạn sang 518, mã đặt phòng vẫn y nguyên.
Thử in số phòng lên email xác nhận xem, bạn sẽ gặp đủ mọi vấn đề ở trên: khách gõ cửa phòng 411, người lạ đếm được số phòng, và một đợt sửa sang làm hỏng mọi booking.
Định danh trong database cũng làm đúng hai việc đó, và mỗi việc cần một thứ khác nhau:
| Yêu cầu | Khóa join (số phòng) | Định danh public (mã đặt phòng) |
|---|---|---|
| Kích thước | càng nhỏ càng tốt | đủ nhỏ là được |
| Thứ tự giá trị mới | tăng dần tuyệt đối là lý tưởng | gần tăng dần là có lợi |
| Ai sinh ra | một bộ đếm trung tâm là đủ | ai cũng sinh được, trước khi có bản ghi |
| Người ngoài đếm được không? | không quan trọng | tuyệt đối không |
| Giữ nguyên khi đổi cách lưu? | không quan trọng | bắt buộc |
Không kiểu dữ liệu nào thắng ở mọi dòng của bảng này, nên tôi thôi bắt một cột gánh cả hai.
Sao không mã hóa bigint, hay dùng UUID cho mọi thứ?
Lần nào bàn chuyện này cũng có ba cách sửa được đưa ra, và mỗi cách chỉ giải được một phần.
Mã hóa bigint bằng Hashids, Sqids hay một phép mã hóa đảo ngược được. URL hết giống bộ đếm, nhưng bên dưới vẫn là bộ đếm: một sequence trung tâm, id chỉ có sau khi insert, một giá trị public dính chặt vào khóa lưu trữ. Đổi cách mã hóa là mọi link cũ gãy hết.
UUIDv4 cho mọi thứ. Không đoán được, sinh ở đâu cũng được, nhưng ngẫu nhiên hoàn toàn, nên mỗi lần insert rơi vào một chỗ ngẫu nhiên trong index. Khi index lớn hơn bộ nhớ thì chuyện này bắt đầu đắt. Và mọi foreign key giờ đều dài 16 byte.
UUIDv7 cho mọi thứ. Nói thật, với service nhỏ thì ổn. Nhưng nó làm mọi foreign key nội bộ và index của chúng to gấp đôi, và lại gộp id public với khóa join vào cùng một cột.
Quy ước của nền tảng chốt chuyện này trong một dòng: primary key và khóa join cục bộ là BIGINT; tham chiếu public và tham chiếu xuyên service là UUIDv7 do ứng dụng sinh ra.
Schema "bigint bên trong" trông thế nào?
Đây là một bảng được trỏ tới từ bên ngoài và một bảng con nội bộ của nó, viết bằng Prisma, đã lược chỉ còn những trường liên quan:
model Order {
  id               BigInt               @id @default(autoincrement())
  publicId         String               @unique @db.Uuid
  orderNumber      String               @unique @db.VarChar(40)
  tenantPublicId   String               @db.Uuid
  customerPublicId String?              @db.Uuid
  version          Int                  @default(1)
  createdAt        DateTime             @default(now()) @db.Timestamptz(3)
  history          OrderStatusHistory[]

  @@index([customerPublicId, createdAt(sort: Desc), publicId(sort: Desc)])
}

model OrderStatusHistory {
  id        BigInt   @id @default(autoincrement())
  orderId   BigInt
  toStatus  String   @db.VarChar(30)
  createdAt DateTime @default(now()) @db.Timestamptz(3)
  order     Order    @relation(fields: [orderId], references: [id])
}
Đọc nó như đọc sổ khách sạn:
idlà số phòng: 8 byte, chỉ tăng, mọi bản ghi con đều dùng nó.OrderStatusHistory.orderIdcũng 8 byte, mỗi entry trong index trên cột đó cũng vậy.publicIdlà mã đặt phòng. Kiểuuuidgốc của PostgreSQL lưu nó dưới dạng 16 byte nhị phân, đúng như RFC 9562 khuyến nghị thay vì 36 ký tự text.orderNumberlà id thứ ba, để con người đọc cho nhau nghe. Nó không bao giờ dùng để join.tenantPublicIdvàcustomerPublicIdlà mã đặt phòng của service khác: UUID có index nhưng không có foreign key, vì bản ghi mà chúng trỏ tới nằm ở database khác.OrderStatusHistorykhông cópublicId. Không ai bên ngoài trỏ tới một dòng lịch sử cụ thể; họ đọc lịch sử thông qua đơn hàng.
Quy tắc cuối cùng là quan trọng nhất. Một bảng chỉ có id public khi bên ngoài thật sự cần trỏ tới từng bản ghi của nó. Trong schema của order service, 43 trên 50 bảng có id kiểu bigint, và chỉ 23 bảng có publicId.
Có một chi tiết của PostgreSQL cần nói cho công bằng: khác với InnoDB, secondary index của PostgreSQL trỏ tới vị trí vật lý của dòng, không trỏ tới primary key. Nên một khóa rộng chỉ tốn ở index của chính nó, ở các foreign key tham chiếu tới nó và index trên các cột đó, chứ không phải ở mọi index. Có vài chục bảng con thì vậy cũng đã nhiều rồi.
UUIDv7 là gì?
UUIDv7 là một UUID 128 bit mà 48 bit đầu là Unix timestamp tính bằng mili giây. RFC 9562 mô tả bố cục như sau:
 48 bits      4 bits  12 bits   2 bits  62 bits
 unix_ts_ms | ver   | rand_a  | var   | rand_b
Vì timestamp đứng đầu, id sinh ở mili giây sau sẽ xếp sau id sinh ở mili giây trước. 74 bit còn lại là ngẫu nhiên, nên không ai đếm được. Nó giống một mã đặt phòng bắt đầu bằng ngày: không đoán được, nhưng được xếp theo thời gian.
Đây là hàm sinh dùng chung, bỏ phần kiểm tra đầu vào:
import { randomBytes } from 'node:crypto';

export function createUuidV7(now = Date.now()): string {
  const bytes = randomBytes(16);
  for (let i = 0; i < 6; i += 1) {
    bytes[i] = Number((BigInt(now) >> BigInt((5 - i) * 8)) & 0xffn); // 48 bit mili giây, big-endian
  }
  bytes[6] = (bytes[6] & 0x0f) | 0x70; // version 7
  bytes[8] = (bytes[8] & 0x3f) | 0x80; // variant theo RFC 9562
  return format(bytes);
}

function format(bytes: Buffer): string {
  const hex = bytes.toString('hex');
  return `${hex.slice(0, 8)}-${hex.slice(8, 12)}-${hex.slice(12, 16)}-${hex.slice(16, 20)}-${hex.slice(20)}`;
}
Không có counter, nên hai id sinh trong cùng một mili giây sẽ xếp ngẫu nhiên với nhau. Không chỗ nào dựa vào thứ tự tuyệt đối: danh sách sort theo createdAt và chỉ dùng publicId để phân xử khi trùng, đó là lý do có composite index trong schema.
Cái giá của việc đặt thời gian lên đầu là ai cầm id cũng đọc được nó:
const createdAt = (id: string) => new Date(parseInt(id.slice(0, 8) + id.slice(9, 13), 16));

createdAt(createUuidV7()); // đúng thời điểm hiện tại, tới từng mili giây
Thường thì vô hại, nhưng không phải lúc nào cũng vậy.
Vì sao ứng dụng sinh id chứ không phải database?
Vì id phải tồn tại trước khi có bản ghi.
Khi order service tạo đơn, nó ghi đơn hàng, bản ghi saga và một outbox event trong cùng một transaction, và event được gắn key bằng public id của đơn. Nếu để database sinh id, code phải insert, đọc id ngược lên, rồi mới dựng event được. Sinh id trước thì bản ghi, event và response dùng chung một giá trị ngay từ dòng đầu của handler. Phần còn lại của transaction đó nằm trong bài về transactional outbox.
Còn một lý do thực tế nữa. Stack Compose và CI trong repository đang chạy PostgreSQL 17, bản này chưa có hàm sinh UUIDv7; uuidv7() chỉ có từ PostgreSQL 18. RFC 9562 có nói một database nguyên khối duy nhất có thể cho thứ tự tốt nhất, nhưng với mười ba database và một trình duyệt cũng tự sinh UUIDv7 làm idempotency key, lợi thế đó không áp dụng được ở đây.
UUIDv7 dẫn xuất là gì, khi nào cần?
Có những id không nên ngẫu nhiên chút nào. Khi outbox của order service bỏ cuộc với một event, nó ghi một dead-letter event. Nếu dead letter đó nhận id ngẫu nhiên mà nhánh xử lý lỗi chạy hai lần, bạn có hai dead letter cho cùng một lỗi.
Nên thư viện dùng chung có thêm một hàm: cùng id nguồn, cùng nhãn thì luôn ra cùng một UUIDv7.
import { createHash } from 'node:crypto';

export function createDerivedUuidV7(source: string, discriminator: string): string {
  const bytes = createHash('sha256').update(`${source}-${discriminator}`).digest().subarray(0, 16);
  Buffer.from(source.replaceAll('-', ''), 'hex').copy(bytes, 0, 0, 6); // giữ timestamp của id nguồn
  bytes[6] = (bytes[6] & 0x0f) | 0x70;
  bytes[8] = (bytes[8] & 0x3f) | 0x80;
  return format(bytes);
}

// Trong order outbox: mỗi event lỗi chỉ có một dead letter, chạy lại bao nhiêu lần cũng vậy.
const deadLetterId = createDerivedUuidV7(event.eventId, deadLetterEventType);
Ở khách sạn, đây là yêu cầu trả phòng muộn của booking K7QX2M, lúc nào cũng được lưu là K7QX2M-LATE. Lưu hai lần thì bản trùng lộ ra ngay. Trong database, unique constraint lo việc phát hiện đó. Một projection cũng dẫn xuất id thông báo cho admin từ id của event đầu vào theo cách y hệt, nên replay event không thể gửi thông báo hai lần.
Chép 48 bit đầu từ id nguồn giúp id dẫn xuất nằm ngay cạnh id cha trong index. Giữ version là 7 giúp mọi chỗ kiểm tra z.uuidv7() trong hệ thống đều chấp nhận nó. Ai kỹ tính sẽ chỉ ra rằng RFC 9562 muốn các bit còn lại phải ngẫu nhiên, nên một UUID nhồi giá trị hash thì gần với version 8 hơn. Nói vậy cũng đúng; tôi chọn tương thích với validator hơn là đúng chuẩn tuyệt đối.
Id dẫn xuất thì đoán được, và đó là chủ ý. Điều này chỉ chấp nhận được vì ở đây không id nào được coi là bí mật. Chuyện này tôi quay lại ngay sau phần index.
Vì sao UUID ngẫu nhiên làm chậm B-tree index?
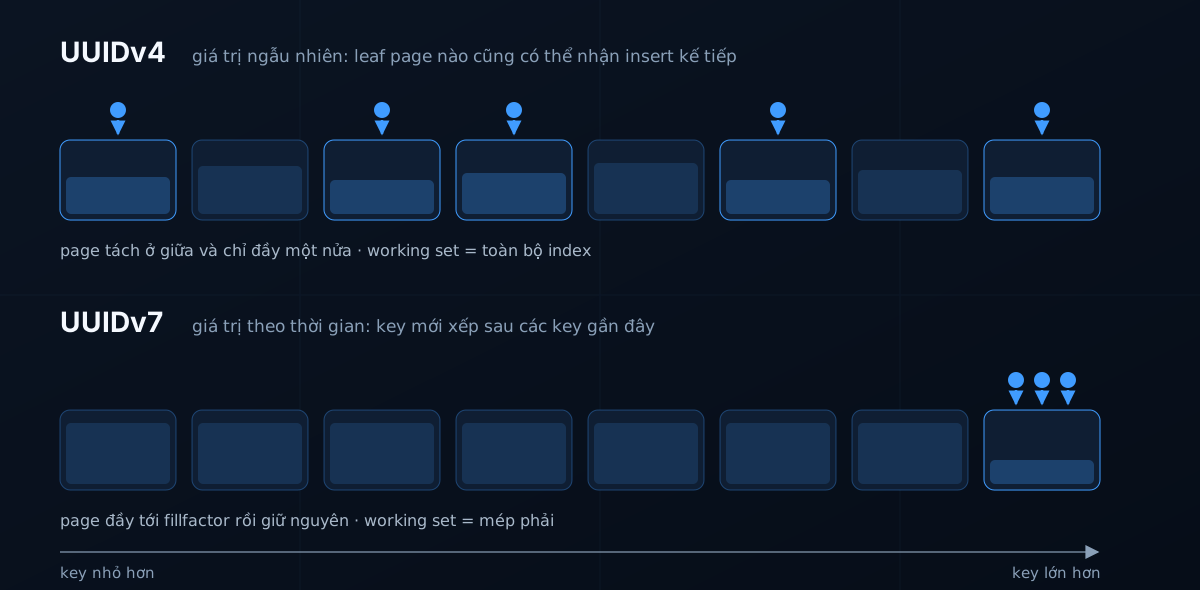
B-tree giữ các key theo thứ tự trên các leaf page, và key mới nằm ở đâu chỉ phụ thuộc vào giá trị của nó.
Hình dung kho lưu phiếu đặt phòng của khách sạn, xếp theo thứ tự trong một trăm ngăn tủ. Nếu mã ngẫu nhiên, booking hôm nay rải khắp các ngăn trong phòng. Nếu mã bắt đầu bằng ngày, mọi booking hôm nay đều vào ngăn cuối cùng, ngay trên bàn nhân viên.
UUIDv4 là kho thứ nhất. Mỗi lần insert rơi vào một leaf page ngẫu nhiên, nên khi index lớn hơn bộ nhớ, phần lớn các lần insert phải chờ đọc page từ đĩa trước. Page đầy thì split ra làm hai, mỗi bên chỉ đầy chừng một nửa. Giữa hai lần checkpoint có nhiều page khác nhau bị sửa hơn, nên WAL (write-ahead log) phải ghi thêm nhiều full-page image. Working set là toàn bộ index.
UUIDv7 là kho thứ hai. Giá trị mới lớn hơn gần như mọi thứ đã có, nên insert dồn vào các leaf page ngoài cùng bên phải, vốn luôn nằm trong cache. Khi PostgreSQL mở rộng B-tree ở mép phải, nó lấp leaf page tới mức fillfactor, mặc định 90%, thay vì chia đôi. Working set chỉ là mép phải.
RFC 9562 nói khoảng cách giữa hai kiểu có thể "one order of magnitude or more", tức gấp mười lần hoặc hơn. Tôi chưa benchmark trên nền tảng này, nên hãy coi lập luận của tôi là về mặt cấu trúc. Bạn có thể tự xem hình dạng của nó trên PostgreSQL 18:
CREATE EXTENSION IF NOT EXISTS pgstattuple;
CREATE TABLE ids_v4 (id uuid PRIMARY KEY);
CREATE TABLE ids_v7 (id uuid PRIMARY KEY);

INSERT INTO ids_v4 SELECT gen_random_uuid() FROM generate_series(1, 1000000);
INSERT INTO ids_v7 SELECT uuidv7()          FROM generate_series(1, 1000000);

SELECT 'v4' AS kind, index_size, avg_leaf_density FROM pgstatindex('ids_v4_pkey')
UNION ALL
SELECT 'v7', index_size, avg_leaf_density FROM pgstatindex('ids_v7_pkey');
So sánh mật độ leaf page và kích thước index. Đây là hình dạng page, chưa phải I/O; chi phí I/O chỉ lộ ra khi index không còn vừa bộ nhớ. Thiệt hại cũng chỉ nằm ở index: heap của bảng PostgreSQL không sắp theo key nào, nên id ngẫu nhiên không làm xáo trộn chính bảng.
Public id và bigint gặp nhau ở đâu?
Public id đi vào, public id đi ra. bigint không bao giờ ra khỏi repository.
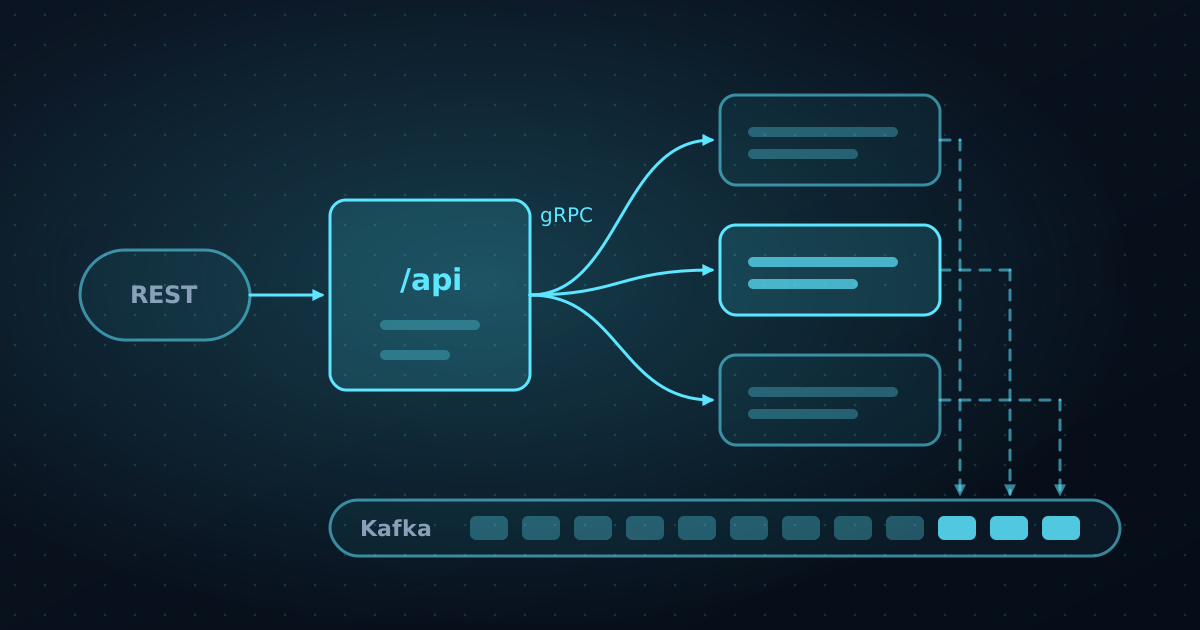
Cùng đi theo một request GET /orders/{orderId}. Gateway chuyển path xuống (chuyện định tuyến nằm trong bài REST ở biên, gRPC và Kafka bên trong). Controller loại mọi thứ không phải UUIDv7 trước khi chạy bất kỳ query nào:
export const orderPublicIdSchema = z.uuidv7();

@Get(':orderId')
@Authenticated()
async get(
  @ZodParam('orderId', orderPublicIdSchema) orderId: string,
  @CurrentUser() user: AuthenticatedUser,
) {
  return this.orders.getForActor(orderId, user);
}
Service tải đơn theo public id, rồi kiểm tra ai đang hỏi. Bản rút gọn:
async getForActor(orderId: string, actor: AuthenticatedUser): Promise<OrderData> {
  const order = await this.orders.findByPublicId(orderId); // đi qua unique index trên publicId
  const ownsOrder = order?.placedByAccountPublicId === actor.sub;
  if (!order || !(ownsOrder || this.hasScopedReadAccess(order, actor))) {
    throw new NotFoundException(ORDER_ERROR.NOT_FOUND);
  }
  return mapOrderData(order); // orderId trong response chính là publicId; id không bao giờ được chép ra
}
Truy vấn đi qua unique index trên publicId, còn join xuống bản ghi con chạy trên foreign key bigint mà không ai phải viết tay. Kiểm tra quyền sở hữu so public id với public id: tham chiếu tài khoản của đơn so với sub trong JWT. Và đơn bạn không được xem sẽ trả 404 chứ không phải 403, vì 403 chẳng khác nào xác nhận id đó có tồn tại.
Giữa các service, quy tắc này được đẩy lên một tầng. customerPublicId không có foreign key; nó được kiểm tra ở biên contract và đối soát qua event hoặc job, vì mỗi service sở hữu database riêng (xem database per service và saga). Event Kafka mang public id của đơn trong aggregateId, và relay dùng nó làm message key, trừ khi event đặt partition key khác.
Id khó đoán có đủ để bảo vệ tài nguyên không?
Không. RFC 9562 viết rõ: không nên mặc định UUID là khó đoán, và không được dùng UUID như security capability, tức loại định danh mà chỉ cần cầm là có quyền truy cập. Id rò rỉ qua ảnh chụp màn hình, log, ticket hỗ trợ, còn id dẫn xuất thì vốn đoán được.
Decision record của nền tảng nói thẳng: id không tuần tự làm việc dò quét khó hơn, nhưng không ngăn được lỗi IDOR (insecure direct object reference); phân quyền mới là lớp bảo vệ thật. Cheat sheet về IDOR của OWASP cũng nói vậy. Ở khách sạn, lễ tân vẫn kiểm tra hộ chiếu của bạn.
Id thứ hai tốn gì?
- Hai unique index trên mỗi bảng được trỏ tới, cái UUID rộng gấp đôi. Mỗi lần insert phải cập nhật cả hai.
- Thêm một lần dò index mỗi lần đọc để đổi public id ra bản ghi trước khi join bằng
bigint. - Kỷ luật. Sớm muộn gì cũng có người trả
idra response. Đặt tên rõ ràng giúp được:idlà nội bộ,publicIdlà của mình để chia sẻ,customerPublicIdlà của người khác. JavaScript cũng vô tình giúp một tay: Prisma trả cộtBigIntvề kiểubigint, màJSON.stringifythì némTypeError: Do not know how to serialize a BigInt, nên mộtidlọt ra ngoài thường vỡ ầm ĩ ngay lúc dev. - Timestamp bị công khai. Nếu thời điểm tạo của một loại tài nguyên là nhạy cảm, hãy cho nó UUIDv4 và chấp nhận chi phí index.
- Toàn vẹn dữ liệu giữa các service chỉ còn là eventual. Validation và đối soát thay cho foreign key, và cả hai đều là code bạn phải tự viết, tự test.
Khi nào một id là đủ?
- Một ứng dụng, một database, không có API public: dùng
bigint, khỏi cần cột thứ hai. - Service nhỏ, vài bảng, id đi ra ngoài nhiều: dùng UUIDv7 làm primary key duy nhất là hoàn toàn hợp lý.
- Bảng không ai join tới: ngay trên nền tảng này, bảng inbox ghi lại các event đã tiêu thụ cũng chỉ dùng UUID của event đầu vào làm khóa.
Nếu làm lại, tôi sẽ làm khác gì?
Quyết định thì vẫn đứng vững. Chỗ tôi muốn làm khác là cách triển khai, và chính decision record cũng ghi rằng việc áp dụng mới ở mức một phần.
Xóa default v4. Service định danh chưa bao giờ được tách: hơn một nửa số bảng của nó dùng UUID làm primary key, nên id của tài khoản vừa là số phòng vừa là mã đặt phòng. Các cột đó vẫn ghi @default(uuid()), mà trong Prisma thì nó sinh UUID ngẫu nhiên, tức v4. Mọi luồng tạo tài khoản hiện đều truyền createUuidV7() tường minh, nhưng default vẫn nằm đó làm phương án dự phòng âm thầm. Chỉ cần một luồng mới quên truyền id là một UUID v4 nằm gọn trong cột mà quy ước nói là v7, không lỗi gì cả. Bỏ default đi thì Prisma bắt buộc id trong input khi create, và quên truyền sẽ thành lỗi compile.
Validate ở một cửa. Hiện validation làm theo từng route. Trong cùng order controller, phần lớn route dùng @ZodParam('orderId', z.uuidv7()), còn một route tự parse path bằng tay. Decision record cấm nói rằng gateway validate mọi path id cho tới khi có integration test chứng minh. Tôi sẽ đặt một bước validate dùng chung ở biên ngay từ endpoint đầu tiên.
Gắn nhãn cho kiểu. Với compiler, orderPublicId: string và customerPublicId: string là một. Một branded type như PublicId<'Order'> biến việc truyền nhầm thành lỗi compile: rẻ nếu làm từ ngày đầu, cực nếu phải sửa về sau.
Test chung hai hàm sinh, và đo trước khi nói. Backend và trình duyệt mỗi bên giữ một hàm sinh UUIDv7 riêng, nên cần một contract test chạy trên cả hai. Và tôi sẽ chạy thí nghiệm index ở trên với một schema sát thực tế trước khi viết chữ "nhanh hơn" vào bất kỳ tài liệu thiết kế nào.
Cuối cùng, cứ giữ createdAt. Thời gian bên trong UUIDv7 đến từ đồng hồ của máy nào sinh ra nó. Đó là gợi ý về vị trí trong index, không phải cái đồng hồ.
Tóm tắt
- Một định danh làm hai việc: khóa join bên trong và định danh cho bên ngoài. Khi service có nhiều join và id đi xa, hãy cho mỗi việc một cột riêng.
bigintbên trong: 8 byte, tăng dần, không bao giờ ra khỏi repository.- UUIDv7 bên ngoài: insert luôn ở mép phải index, người ngoài không đếm được, và ứng dụng sinh được trước khi có bản ghi.
- Dẫn xuất id một cách tất định khi retry hay replay phải ra đúng id cũ.
- Id không bao giờ là quyền. Kiểm tra quyền ở mọi lần đọc, và trả 404 cho thứ người gọi không được thấy.
- Bỏ những default âm thầm sinh sai loại id.
Cột version trong schema ở trên là nơi phần tiếp theo bắt đầu: idempotency key và optimistic locking để retry an toàn.